
AI文献综述会编参考文献医学科研的3个真实对策
AI文献综述会编参考文献?医学科研的3个真实对策
有位做医学科研的读者跟图老师讲过一次惨痛返修。
综述投出去,审稿人回了条意见,参考文献里有两条查无此文。
他拿着那两条去数据库里翻,确实不存在,作者、标题、期刊、年份,样样像真的,就是没有这篇文章。
用大模型写综述的人,踩这个坑的不在少数。
今天把这事讲透,再给3个真实对策。

AI为什么会编文献
先把原因讲清楚,不冤枉它,也不好高估它。
大模型的工作方式是接话,你问一个观点,它顺着往下生成一段最像答案的话。
参考文献也是生成出来的,作者名字、年份、期刊名,每个字段都像模像样,组合起来却可能不存在。
它没有恶意,也没有一个文献库在背后撑着,它只是在生成一段看起来可信的文字。
问题出在人把生成的结果直接当了检索的结果。
生成的意思是我编的,检索的意思是我查到的,这两个差别,在参考文献这件事上就是返修和不返修的差别。
明白这一层,对策就顺理成章了。
对策一文献只从库里来
第一个对策,也是最根本的一条,让AI只从真实文献库里调东西。
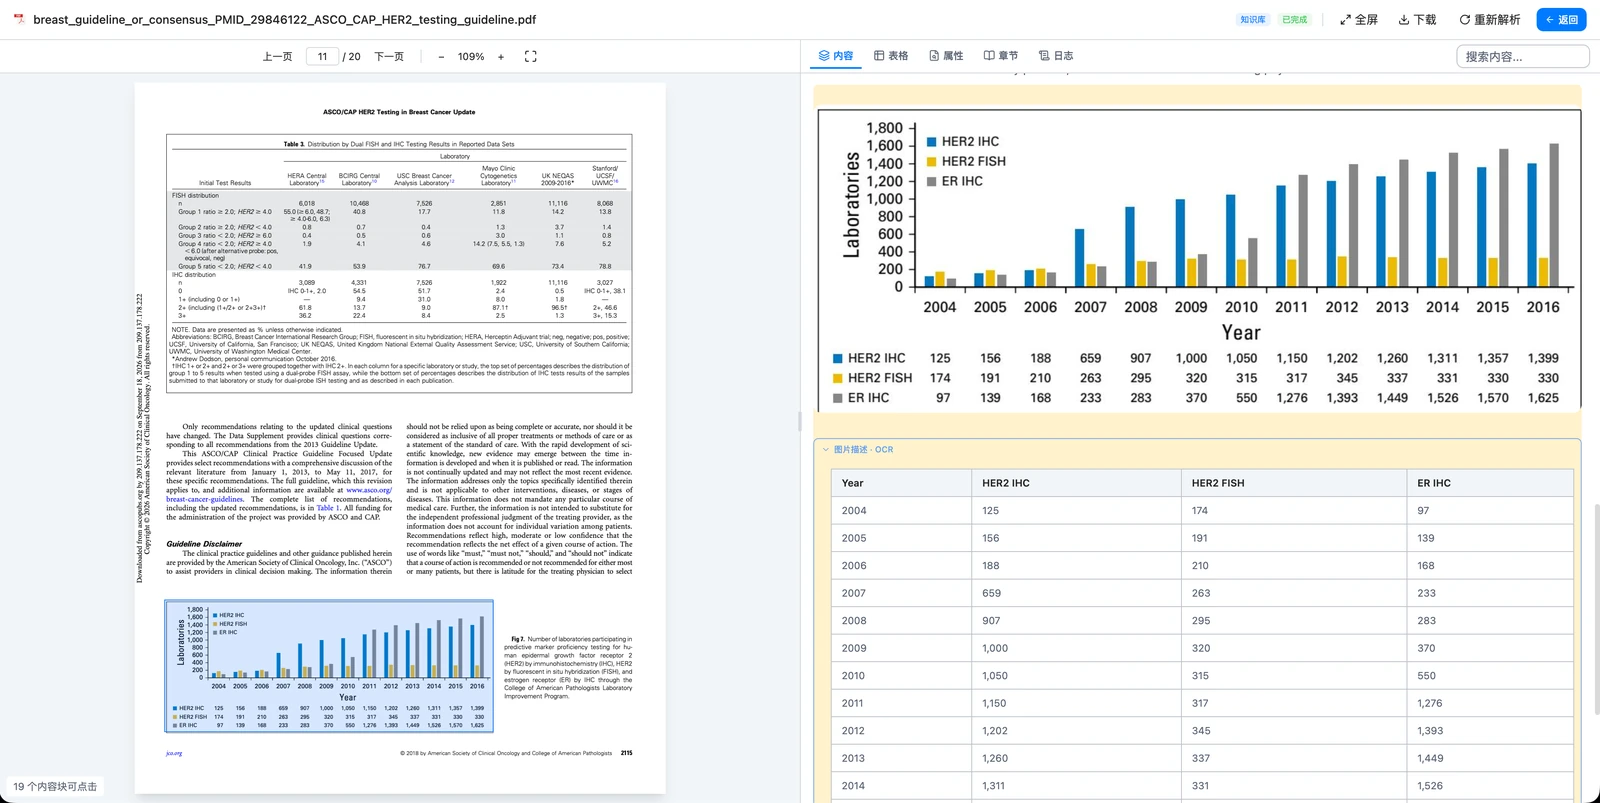
团队把自己的文献库建起来,综述相关的文献,一篇篇真实入库,临床研究的全文和补充材料也在其列,疗效数据、不良反应数据,综述里最常引的就是这些。
AI的工作范围被限定在这个库里,给出的每条参考文献,都是库里真实存在的。
库里没有的,它给不出来,这个约束反而成了保障。
这条路对文献入库的要求不低,PDF的格式五花八门,扫描版、双栏排版、表格里套参考文献,解析不好,库就白建。
图博数智的inFab在这上面是下了功夫的,16+种文件格式,复杂文件95%以上精准解析,文献里的数据进库就是结构化的字段。
南京大学课题组的MatSeek平台跑的就是这套逻辑,文献检索精准度95%以上。
文献入库这一步做完,团队就有了一个只有真实文献的世界,AI在这个世界里说话,编不了。
对策二结论能点回原文
第二个对策,管的是正文里那些引用的观点。
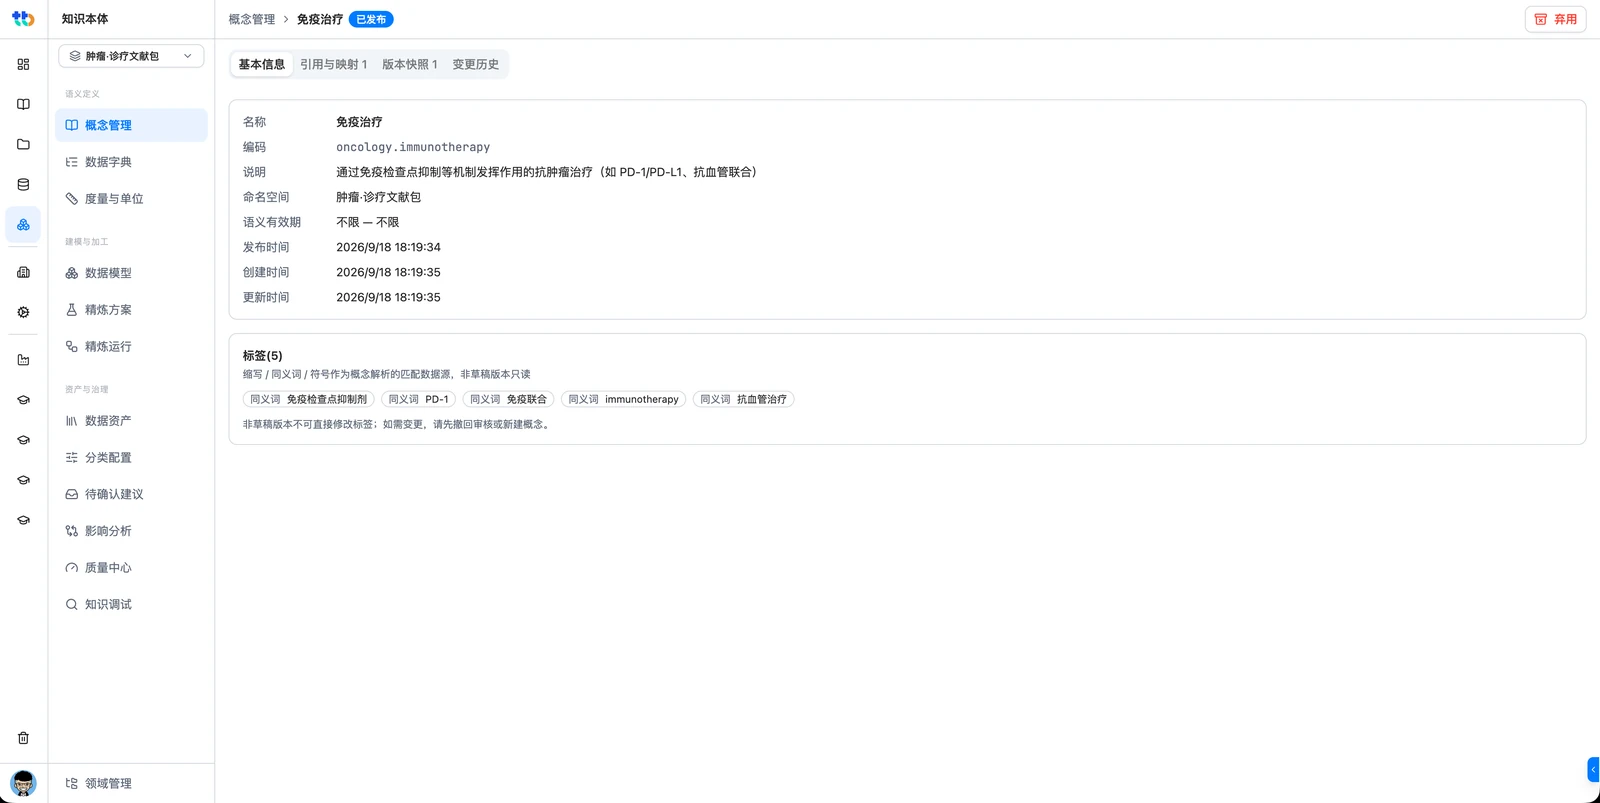
综述正文说,某项研究显示某个结论,这句话的依据是哪篇文献的哪一段,要能一键点回去。
点回去看到的,是原文里的原句,不是AI转述过一遍的大意。
这个能力业内叫溯源,做得细的能定位到引用、字符、表格行、单元格这一级。
为什么这条重要。
因为AI转述会走样,一个效应量,一个置信区间,转一道手就可能变味,审稿人对这种走样最敏感。
每条观点都能点回原文核对,AI才敢用在综述里,这一条没有,前面第一条也白搭。
投稿前自己先照这个标准把全文点一遍,比返修后再跟审稿人解释,省心太多。
对策三观点让人来写
第三个对策,讲人和AI的分工。
综述里有两类内容。
一类是资料性的,文献找了哪些,各自说了什么,观点之间什么关系,这些AI整理得又快又全。
另一类是观点性的,这个领域还有什么争议,证据链缺在哪,下一步该往哪走,这些是综述的灵魂,得人自己写。
AI把第一类包圆,人专注第二类,这个组合出来的综述,又扎实又有想法。
最怕的是反过来,观点让AI生成,资料让人核对,时间花了不少,稿子还是空的。
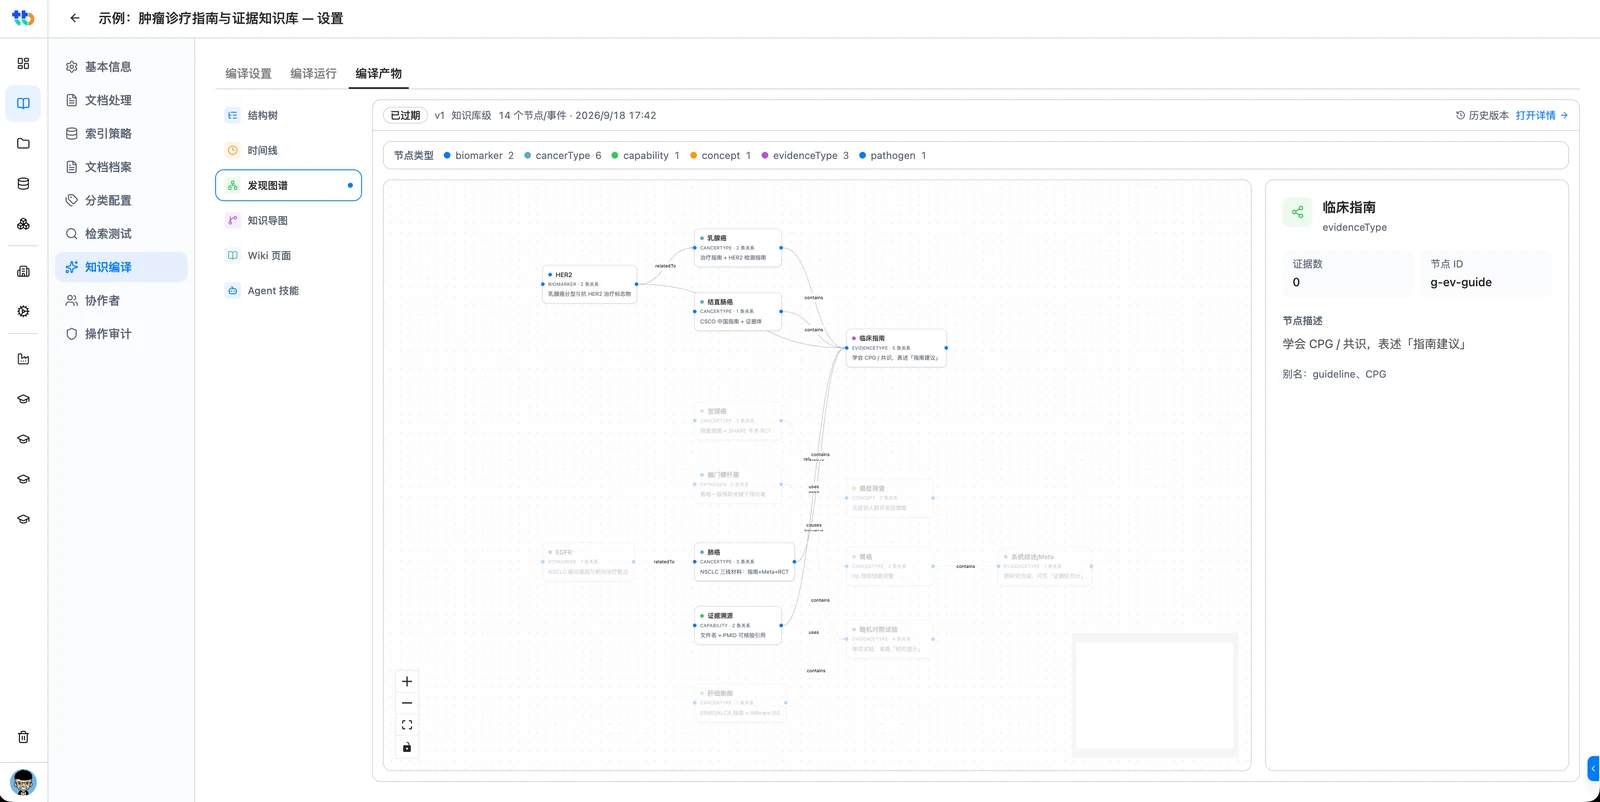
文献之间的关联关系,谁引了谁,谁反对谁,AI梳理完还能建成图谱,这块在图博数智这边是跟业务本体建模一起做的,概念关系建准了,梳理结果才可信。
没发表的综述更要保密
多说一句数据安全。
写在电脑里还没投出去的综述,是没公开的研究思路,属于最不能外泄的那类资产。
把草稿喂给公网AI润色,等于把没公开的想法发到了外面,这个风险比编参考文献还大。
所以前面3个对策的执行环境,都应该是私有化的,文献库在自家服务器,AI在自家环境里跑,断网也能用。

AI辅助综述的边界
图老师在图博数智做inFab交付,这套文献库加溯源的组合,是科研团队用得最多的配置之一,交付的同事里约80%是FDE,直接跟科研人员对接,把文献组织的方式建成团队自己的体系。
3个对策再收拢一下。
文献只从库里来,堵住编造的口子。
结论能点回原文,守住转述不走样。
观点让人来写,保住综述的灵魂。

图博数智目前已经跟多家医疗相关机构及企业有成功的AI实践项目。
一句结论可以单独记下:AI写综述的底线就一条,参考文献必须是检索出来的,不能是生成出来的。
关注我,图老师每天分享一个企业AI落地的真问题、真办法。