
智能体能替质量工程师干什么3个真实实践
智能体能替质量工程师干什么?3个真实实践
最近碰到一个客户的质量总监,聊到年底冲量和AI智能体,他半开玩笑说:我们质量部天天加班,报表比检验还费人。
一个检验员一天看几十批数据,看久了眼睛会麻;一份质检报告从原始记录到成稿,来回复制粘贴两小时;想知道这家供应商最近的批次是不是在变差,翻半年台账翻到头秃。
更别提每年新进厂的检验员,光认全几十个检验项目的判定标准就要小半年,中间还不敢让他独立放行。
他问图老师:都说AI智能体,它到底能替我们质量的人干点啥?会不会又是一个听起来很美、落地就哑火的概念?
这个问题背后其实是两层担心:一层怕白花钱,一层怕出了错算谁的。
今天就讲3个已经跑起来的真实实践,替的都是重复劳动,判定责任还在人手上,两层担心一并拆掉。
智能体自动初判检验数据
第一个实践,检验数据进来先让智能体过一遍。
大多数工厂的现状是:仪器出了数据,检验员一项一项对标准,合格打勾,超标标红,全靠人眼。
量小的时候没问题,量一上来就成了应付:看得快了容易漏,看得慢了报表就压着。
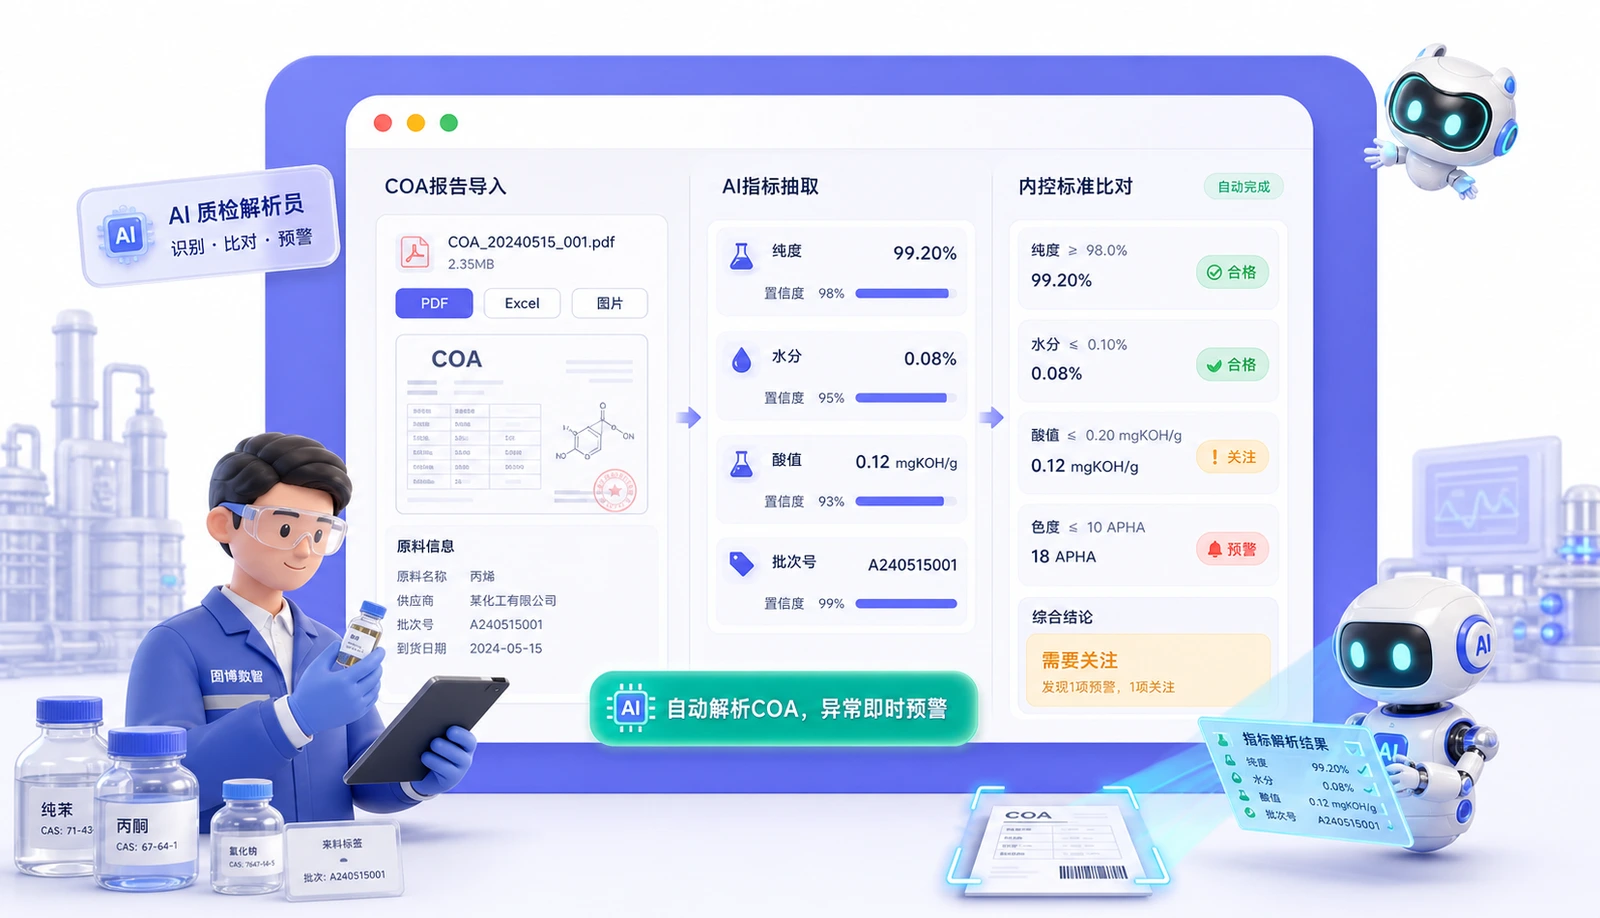
现在的做法是让AI智能体接住原始检验数据,按预先维护的标准自动做初判。
数值在窗口内的直接放行进正常流程,贴近限值的标黄提示,超标的红牌拦下并写清超了哪一项、超了多少。
更细的活它也接得住:同一批样品多个平行样之间离散度不对劲、数值趋势跟历史规律拧着来,这类人眼容易滑过去的隐患,一并标出来。
检验员拿到的已经是一份带标记的清单,只处理例外,不复核全部。
判断口径也好定:数值落在限值九成五以内的算稳,贴近限值的算黄,这条线客户自己说了算,图博数智只负责按线执行。
一家日化客户的质检岗,原来一个上午耗在初判上,现在大约半小时收尾,精力全留给真异常。
标准升版也不用慌,新限值维护进去,下一批数据就按新版判,不存在有人还在看旧表的漏网情况。
要强调一句:初判是智能体干的,放行签字还是人签,责任边界没有变过。
智能体自动成稿质检报告
第二个实践,把报告这件体力活交出去。
质量部最吐槽的就是报告:原始记录、检验数据、判定结论、审批流程,格式死板,内容琐碎。
一份报告两小时,其中一小时半在排版和复制粘贴,写的人觉得自己在浪费生命。
智能体的干法是按模板自动组稿:检验数据判完,报告初稿同步生成,数据、批次、判定结论对号入座。
样品信息、检验依据、仪器编号这些容易漏的角落,从原始记录里直接带过来,不用人再抄一遍。
偏差项自动带上前面初判的标记和说明,审核人打开就是一份能用的稿子,改改措辞就能提交流程。
原来两小时的活,压到十几分钟的审校,月底集中出报告的那几天,质量部不用再靠泡面续命。
英文报告、客户定制格式也一样:模板换成对方要的版式,数据和结论照旧自动填,不用另雇一个人专门排版。
更实在的是一致性:人写报告,忙起来表述会飘;智能体按同一套模板出稿,同一类报告口径完全统一,审计时翻旧报告不再两眼一抹黑。
原始记录、判定依据、版本信息全程留痕,客户审核或体系检查要溯源,一步就能调出来。
常有工程师问:模板改了、报告改版了怎么办?其实模板就是一份可维护的文件,改一处全组生效,不存在每个人电脑里存着五六个旧版本的情况。
智能体比对历史质量数据
第三个实践,也是质量部最值钱的一个:让历史数据能说话。
质量数据每家厂都攒了一堆,但多数躺在各自批次报告里,互不往来。
日积月累就成了一个怪现象:数据最全的部门,恰恰是最难用上数据的部门。
想问一个稍微复杂点的问题——这批货跟三个月前那批比波动大不大?这家供应商最近十批的某个指标是不是在爬坡?——就得有人去翻、去抄、去对表格。
图博数智的做法是把质量数据结构化存进知识库,批次、供应商、产线、时间全部带上元数据。
智能体接到问题,自己拆解成查询和比对步骤:同批次跨期拉一条线,同供应商跨批次算个趋势,不同产线做一次横向对齐,推理过程全程可追溯,每一步用了哪批数据都摆在那里。
答出来的结果是带着数据、带着批次的完整证据链,拿去跟供应商开质量会议,腰杆是硬的。
供应商悄悄换了工艺、某条产线的某个指标在缓慢漂移,这类靠人翻台账很难逮住的问题,比对几次就现形。
每年做供应商年度评价,也不必再临时抱佛脚凑数据:该有的趋势、该有的比对,全年都是现成的。
真跑起来快的团队,两三周就能拿到第一份跨期比对结果,慢的也就一个多月,差别主要在历史数据理得干不干净。
质量从事后追认,变成事前有数,这中间差的只是一个能自己查数、自己推理的帮手。
图老师在图博数智做inFab交付,智能体这块的原则是先有知识底座、再放智能体干活。
inFab把行业名词和关系建成业务本体,智能体照着本体检索推理,回答带出处,每一步都踩在知识上。
空壳智能体和踩在知识库上的智能体,用一周就能看出差别。
哪些质量团队适合先上
三个实践讲完,落到判断:你们部门适合先切哪个?
检验量大、人盯不动的,先上数据初判;报告写到吐的,先上自动成稿;供应商多、质量波动追不完的,先上数据比对。
不用一口气全上,挑最痛的那件事先跑通,一个月内看到减负,团队才会真心接受。
对了,那位总监最后是拿检验数据初判先开的路:他们家每天检验批次数以百计,人盯不动是实打实的痛。
也有一个前提要说实话:智能体替的是重复劳动,判定标准要人来维护,异常处置的责任还在工程师手上,这个分工别搞混。
图博数智在企业质量场景上的经验是,先把数据底座理干净,智能体才有东西可推理,上来就谈替代人,多半走偏。
数据通了,三个实践其实是连着的:初判标记喂给报告,报告沉淀的数据喂给比对,越用越顺。
从替人做重复活开始,让质量工程师把时间花在真正需要判断的地方,这条路已经验证可行。
关注我,图老师每天分享一个企业AI落地的真问题、真办法。