
同一配方两家工厂做出来不一样3个真实对齐法
同一配方,两家工厂做出来不一样?3个真实对齐法
最近碰到一个客户,质量总监管着两个基地,最头疼的就是配方一致性。
同一张配方单,老厂做出来稳稳当当,新厂隔三差五出状况:粘度偏高、外观发白、批次间波动大,客户投诉基本都攒在新厂这边。
配方是同一版,原料也是集团统一采购,问题出在哪?
他把新厂的工艺员骂了个遍,又从老厂调了两位老师傅过去蹲点,蹲了三个月,没根治。
老师傅回去时留了句话:这边什么都照着做,就是做出来的东西和老家不一样。
图老师说句实话:同一配方做出两个结果,多数问题不在配方上,在工艺对齐上。
今天讲3个真实对齐法,多基地生产的、代工转自产的、新产线爬坡的,都能对号入座。
配方一致性差的真因
先讲排查结论,两厂嘴里的"同一工艺",根本不是同一份。
工艺卡从同一版出发没错,但老厂三年里前后改了十几处,改在哪、为什么改,批注散在几位老师傅自己的本子上。
新厂拿到的,还是三年前那版文件。
再叠加设备新旧程度、车间温湿度、操作习惯的差异,参数名义上一样,实际执行的窗口早就漂了。
举个最常见的例子:同一个"低速搅拌",老厂的减速机和新的不是一档,转速表读数对得上,物料受的剪切完全两回事。
温湿度这条最容易被低估:乳化类工艺,车间温差差个3到5度,搅拌到同样粘度需要的时长能差出一到两成,冬夏两季的投诉曲线经常就是这个形状。
这种漂移平时没人看得见,一到出货、一到夏天冬天换季,全冒出来。
想靠开会吵架吵出结论,吵一年也吵不出来,因为两边拿的数据都对不上口径。
先统一工艺参数版本
第一个对齐法,把工艺卡的版本收拢到一处,两厂必须看同一版。
这话说起来简单,做起来先要解决两件事。
一是什么算"当前有效版本":改动谁审批、怎么生效、旧版怎么作废,要有明确的规则,而不是群里说一声就算改了。
二是改动要带原因:调了搅拌时长,为什么调、依据哪次试验哪个批次,要跟着版本一起留档。
没有原因的改动,三个月后连改的人自己都解释不清,下一个基地就更不敢跟着执行。
很多企业的工艺卡版本管不住,卡就卡在这两处:审批是空的,原因没人填。
图博数智的做法,是把工艺参数建成结构化档案,版本号、生效范围、变更原因放在一处管理,两个基地打开看到的是同一份数据。
老师傅本子上的批注,逐条核实之后正式收编进版本记录,人退休了,经验留在系统里。
收编这件事要趁早:批注这种东西,人走茶凉,三个月没人对,就再也没人说得清那处改动是为什么。
常见的一个疑问是:改动原因非要填吗?实操里给个底线就够用——凡是要动参数范围的,必须留一句依据;只改错别字的,放过它。门槛抬太高,大家就都不填了。
版本对齐了,才谈得上后面的执行对齐。
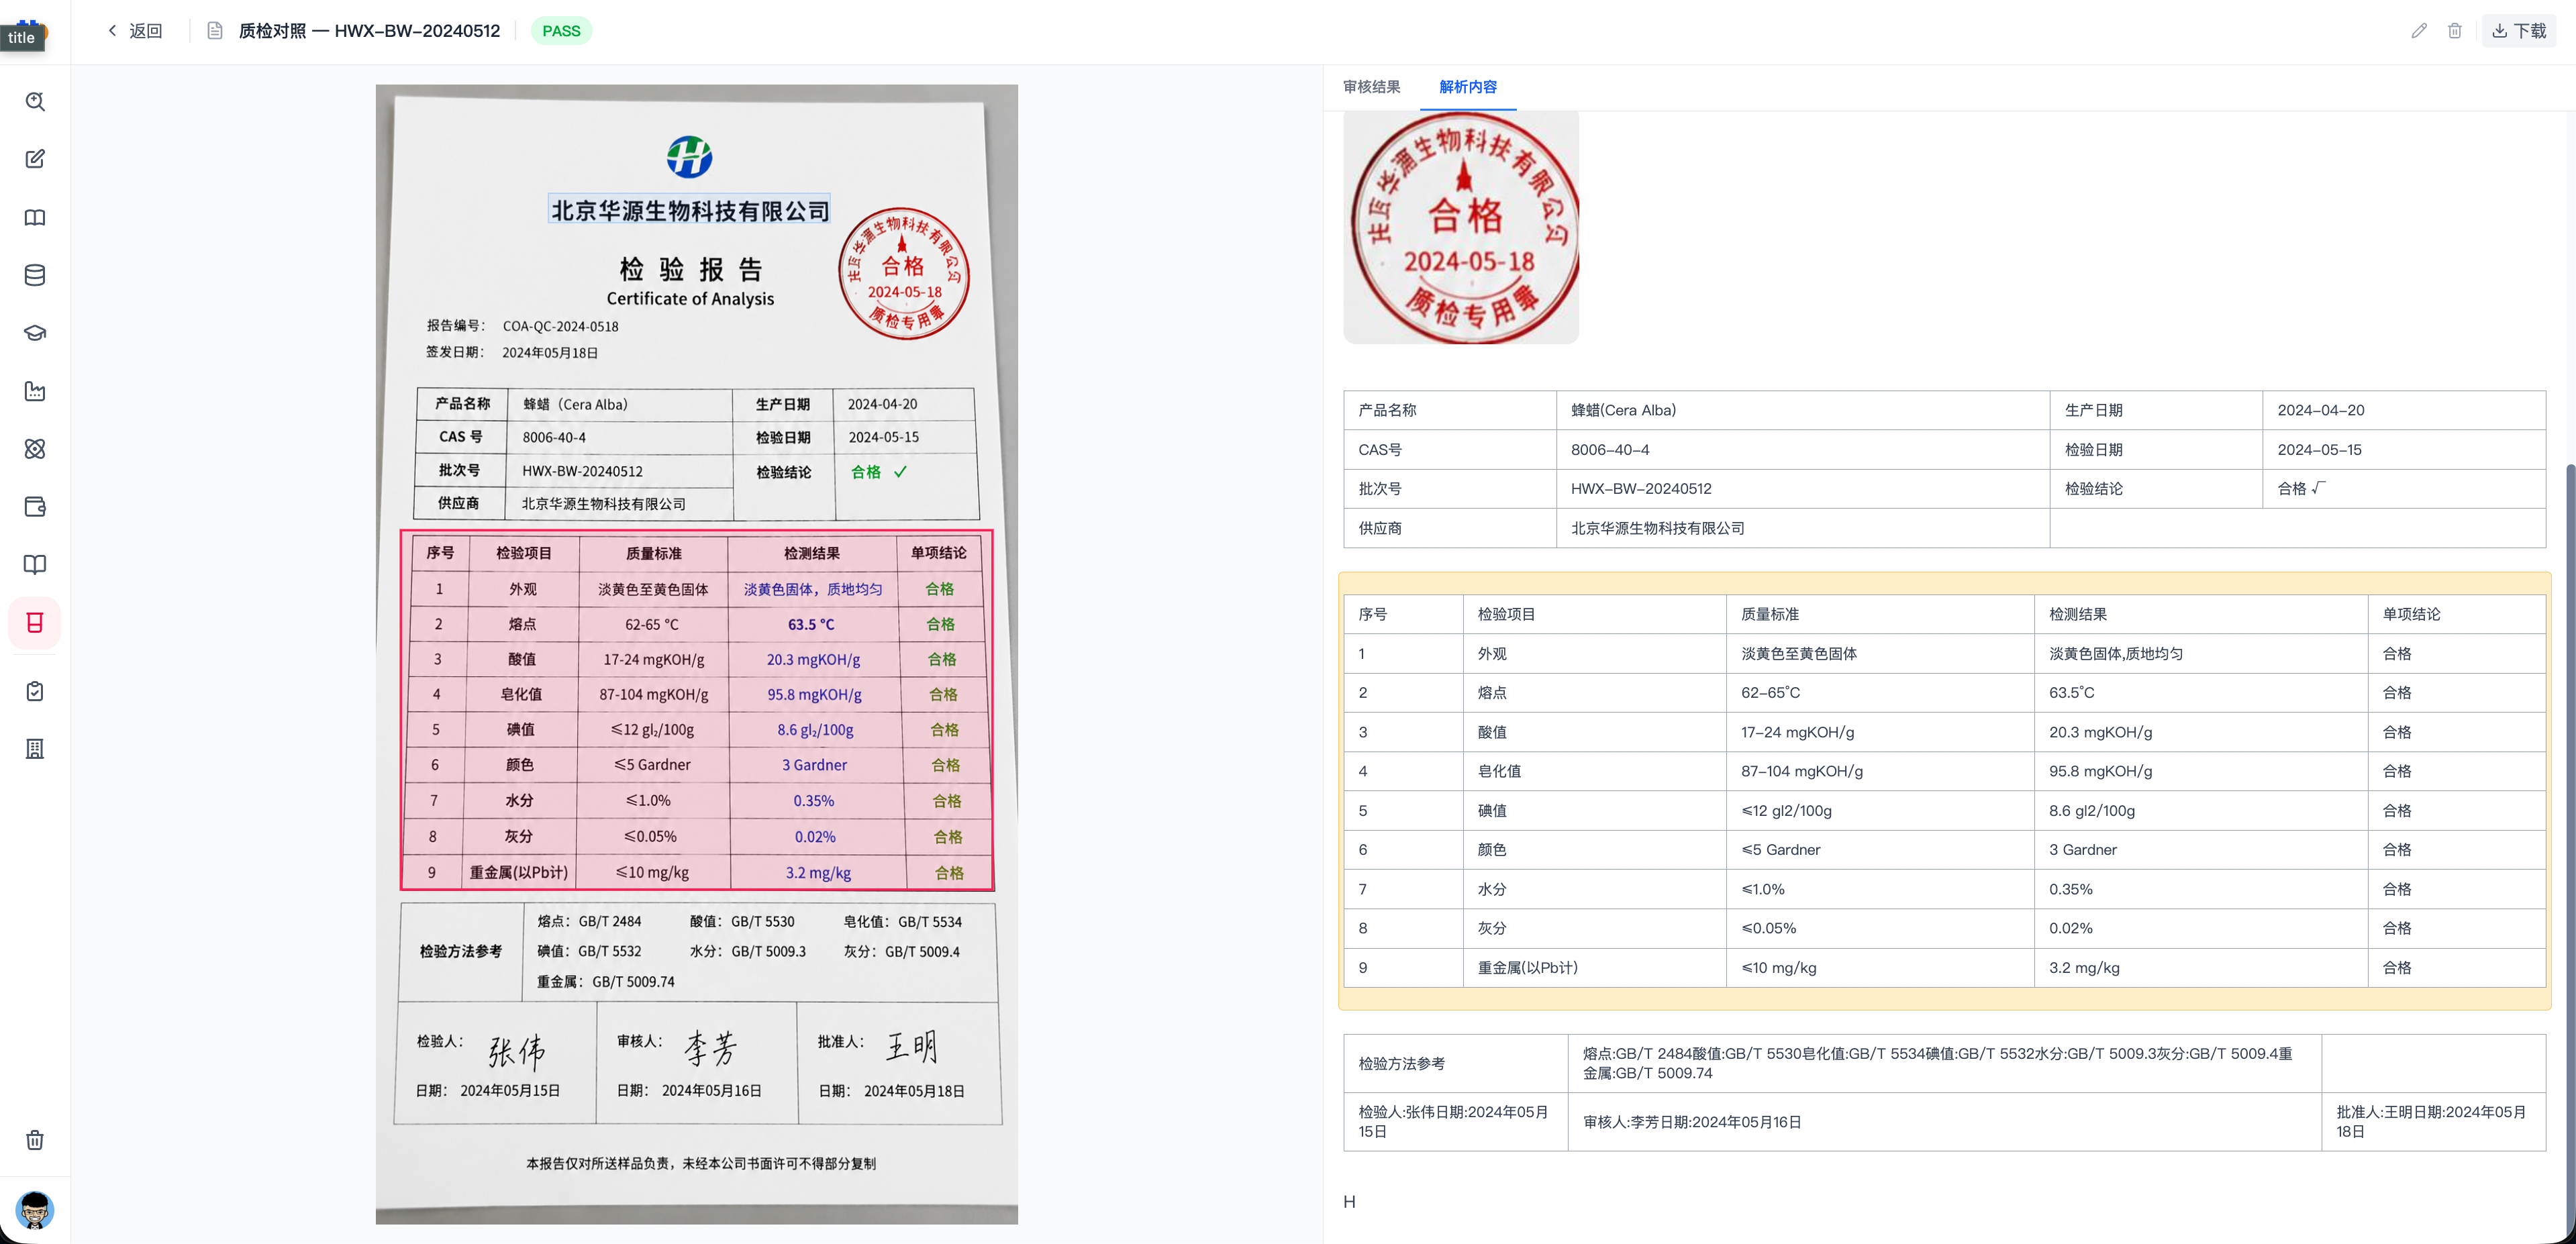
两厂工艺执行偏差比
第二个对齐法,比两厂的实际执行,别停在纸面要求上。
工艺卡写搅拌30分钟,老厂实际落在29到31分钟,新厂落在25到35分钟,这种差距看文件永远看不出来。
把两厂每批的实测参数采集进知识库,同一道工序的数据摆在一起,AI自动标出偏移最大的几个点。
哪家在升温段普遍慢两度,哪家在保温段时长散得没边,一屏看清楚。
这种比对最好按班次、按批次滚动做,因为漂移是渐进的,这个月偏半度,下个月偏一度,攒到换季才爆。
比对报告出来之后,新厂的问题从"感觉老出毛病"变成"第三段温控窗口偏宽、需要收窄",整改第一次有了靶子。
优先收哪个口子也有判断标准:先看偏移大的参数是不是正好压在影响成品指标的工序上,粘度、外观这类客诉高频项对应的工序段,排前面收。
这步的关键是数据要真:靠人工事后补录的参数,比对出来的也是补录的样子,宁可先从自动采集的点位做起。
温度、时长、转速这类能从仪表直采的先上,靠手写记录的环节后面再补,宁少勿假。
同样异常不同工艺因
第三个对齐法,出了异常别照搬另一家的答案。
同样是成品发白,老厂那次查出来是原料水分超标,新厂这次是冷却段温度没压住,表象一样,原因完全不同。
最怕的是质量部拿着老厂的历史结论直接套到新厂头上,药不对症,越治越乱。
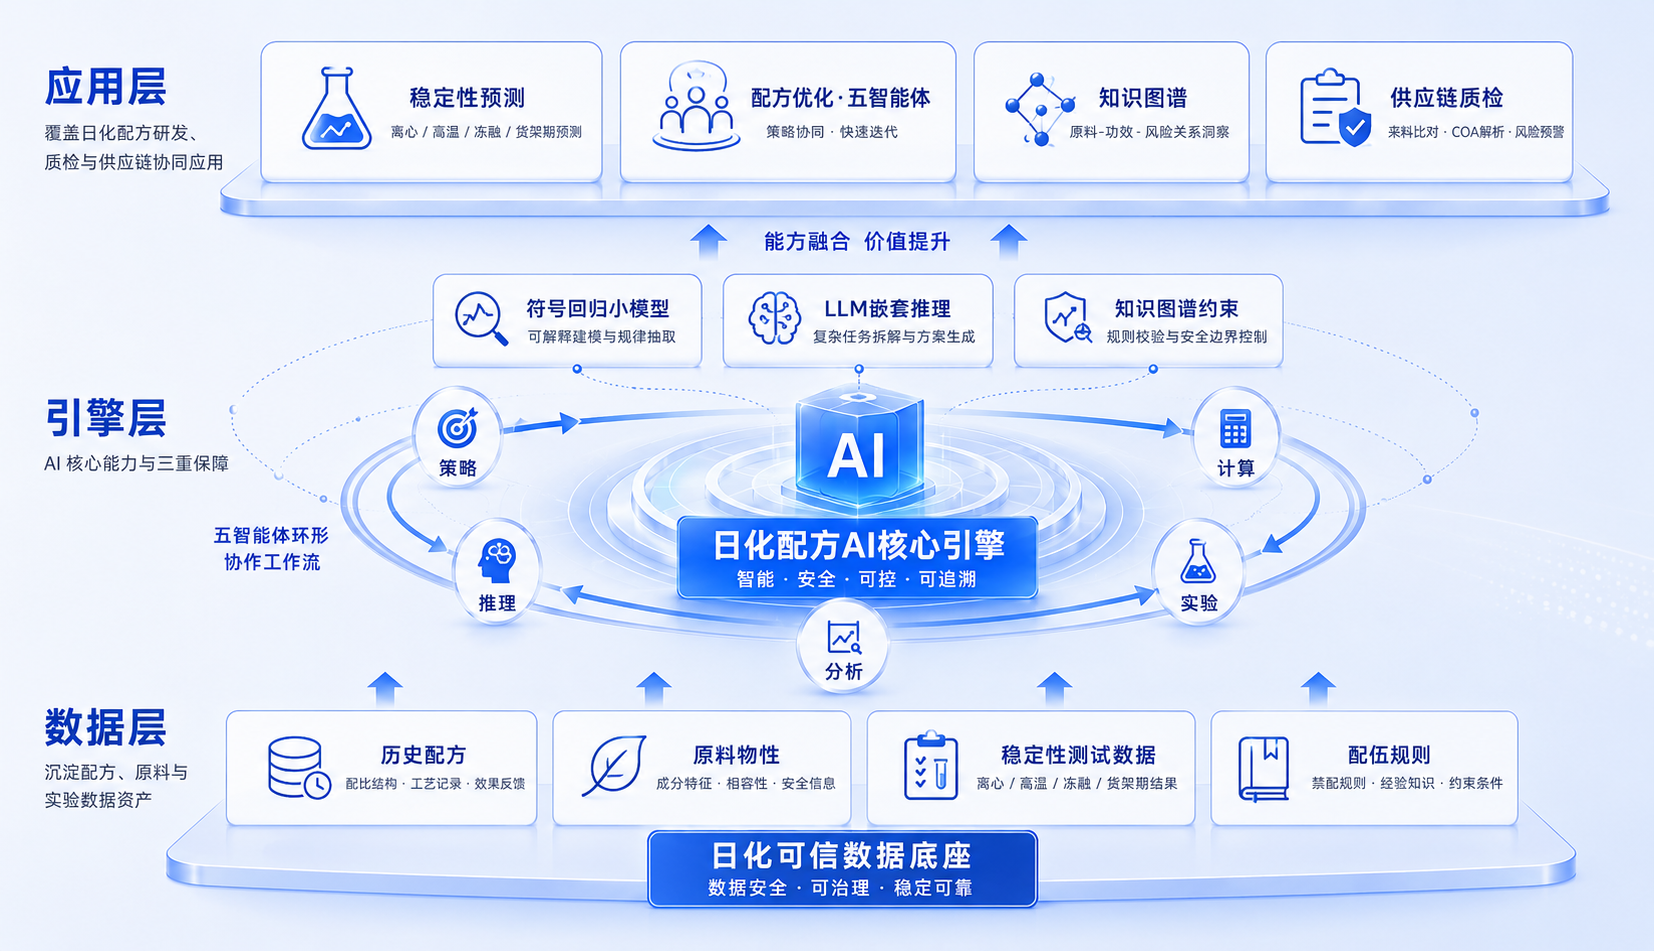
图博数智在企业AI落地里处理这类问题的思路,是把每次异常跟当批的实际工艺条件绑定存档,分厂建账、放在一起比。
新厂再出问题,先查本厂当批的参数记录,AI给出可能原因时,附上当批数据和历史相似案例的出处。
最后一步的判断仍然由工程师拍板,AI的活是把证据摆齐,不是替人下结论。
档案攒上大半年,很多隐性规律会自己站出来:新厂的问题集中在雨季、集中在某个班次、集中在某台设备上,人眼扫不出来的,数据先看出来。
异常档案分开记、合起来比,真正的规律才浮得出来。
这些场景图老师写起来顺手,因为在图博数智做inFab交付时,天天碰的就是这类现场。
inFab先把行业里的名词和关系建成业务本体,配方、文献、实验数据入库先对齐再结构化,AI照着本体回答,结论条条能溯源到原文。
从文件到可信决策,这条链路在inFab上已经跑成产品模块。
配方一致性怎么起步
三个对齐法讲完,收尾给个判断。
先对齐参数版本,再谈别的——版本不统一,后面的偏差比对和异常追溯全是沙子上盖楼。
版本统一之后,优先做执行偏差比对,它见效最快,一两个月就能拿到可以动手整改的抓手。
异常关联可以攒着做,每出一次问题就丰富一次档案,越攒越值钱。
多基地的企业尤其该早点动手:厂越多,一致性漂移的代价是乘法不是加法,早半年收拢,省下的都是反复爬坡的成本。
这套底子打好了,第三个厂、第四个厂接进来就是照搬流程的事,不用每次都从头吵一遍。
先从一个基地、一条产线跑通,再复制到第二个,别一上来就想全网铺开。
什么样的问题按这三步走最灵?两个基地共用配方、投诉总往一边倒、换季就翻车的,先查版本,再比偏差,多半能挖到根上。
那位质量总监后来的反馈也简单直接:版本收拢一个月,新厂的投诉掉了一截,没根治,但终于知道该修哪了。
关注我,图老师每天分享一个企业AI落地的真问题、真办法。