
日化配方AI怎么做才靠谱看与中科院物理所合作的图博数智的3个做法
日化配方AI怎么做才靠谱?看与中科院物理所合作的图博数智的3个做法
最近碰到一个做日化产品的研发负责人,聊到日化配方AI,他一肚子火。
去年看过一场演示,现场问答行云流水,签了合同进场,AI连他们配方表里的原料名都对不上。
问个复配问题,答案看着像模像样,一核对全是编的,工程师用了一周就弃用了。
他问图老师:日化配方AI这东西,怎么做才靠谱?
这个问题值得掰开讲。不看演示看做法,与中科院物理所合作的图博数智在这条线上怎么做的,三个做法,拿去对照你手里的方案。

做法一名词先统一再谈功能
第一个做法,进项目不谈功能,先做业务本体建模。
很多方案死在第一步:AI根本不认识你的配方。
日化行业的名词有多乱,做过配方的都知道。
同一支甘油,配方表写丙三醇,采购系统写品名加规格,老师傅嘴里叫保湿剂;乳化这道工序,有人叫乳化,有人叫均质,记录里还有写打浆的。
这些词人不统一,AI就没法工作。
检测报告里同一种黏度,有的写黏度有的写粘度;稳定性考察叫加速实验的、叫高温烘箱的都有。
你问含丙三醇的配方有哪些,它漏掉一堆写保湿剂的;你查乳化工序的参数,它把均质的记录漏了一半。
漏掉的恰恰可能是那支解决过分层问题的关键配方,错比慢更致命。
图博数智的做法是FDE先驻场把名词捋顺。
配方原料、工序、检测项目,一层一层建本体,别名挂上,对应关系维护进去,同一事物不管写哪种叫法,系统都认得。
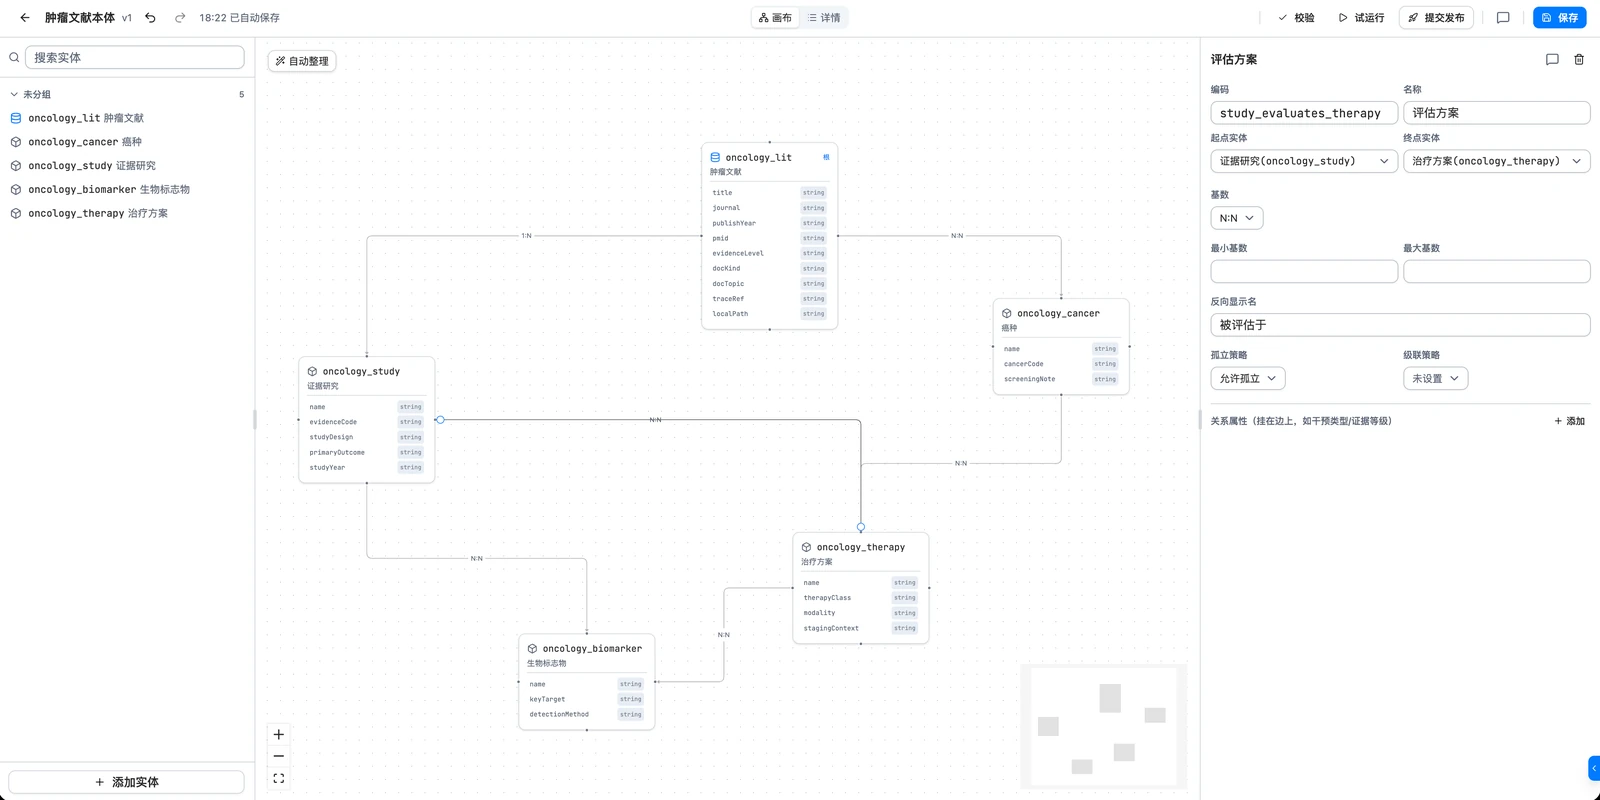
建模期间FDE会拉着配方工程师一条条过,原料挂上CAS号和供应商别名,工序挂上设备和参数维度。
量级上有个参考:中型日化团队一般要梳理2000到5000条原料别名,FDE驻场2到4周,第一版本体才能跑通。
这个过程企业自己也能看到价值:很多团队第一次搞清楚自家配方资产到底有多少家底。
这一步没有酷炫功能,却是后面一切的地基。
名词没统一就上问答,答出来的东西错得悄无声息,比不能用的危害大得多。
评估方案时可以直接问一句:你们进场第一周做什么。
答先做名词梳理和本体建模的,是做过配方场景的。
上来就演示通用问答多智能的,多半在你这个行业没落过地。
做法二先跑真实数据再说效果
第二个做法,方案讲得再好,先拿你的数据跑出来看。
日化企业被演示坑过的不止一家。
演示环境用的是通用语料,问答当然流畅;换到你的配方库、你的实验记录、你的失败案例上,可能就是另一副面孔。
尤其日化配方的提问往往带着前提:同一年龄线的产品、同一剂型、避开某类争议原料。
这种问题通用语料一问三不知,答了也是编的。
靠谱的做法是把这一步变成硬性流程。
从配方研发部门抽一批真实数据,做脱敏处理,让AI在这批数据上回答你们的真实问题。
哪几支配方曾出现过分层,原因各是什么;某个增稠体系的历史用量区间;同类肤感的产品过去踩过什么坑。
答案准不准,研发工程师十分钟就能判断,因为这些都是他们亲手做过的。
判分可以定个硬线:十条真实问题答对八条以上再谈下一步,答对不足五条的,不用纠结,直接换。
与中科院物理所合作的图博数智在这条线上就是这么交付的:先跑真实脱敏数据的Demo,效果说话,再谈方案怎么设计。
这个顺序不能反。
先签合同再验证效果,你赌的是服务商的良心;先验证再签合同,你赌的是它真实的能力。
日化配方这个场景容不得赌,一段错误的配伍建议,可能就是一轮打样加一次客户投诉。
Demo还有个附加好处,顺带摸清对方的交付方式。
跑Demo的过程中,对方问的问题深度、要的数据类型,都在暴露它到底懂不懂配方研发。
只伸手要权限却问不出业务问题的团队,后面大概率也交付不好。
谈方案时把这一条写进流程:不给真实数据Demo的,直接过。
做法三配方数据不出门
第三个做法,跟日化行业的特点直接相关:配方就是命根子。
一家日化企业最值钱的资产,往往就是那几十到几百支核心配方,加上背后的失败记录。
这些数据一旦出门,丢的可能是整条产品线。
日化代工场景里还叠了一层:客户的配方在你手里,保密协议白纸黑字,泄露一次,整条客户线就没了。
所以第三个做法是全私有化部署,配方数据不出本地。
模型、知识库、推理,全部跑在企业自己的环境里,内网断网照样用。
谁看过什么配方、谁导出过哪些记录,权限和审计日志留在自己服务器上,管理层夜里睡得着。
上传公网大模型问配方,问一句等于喂一句,你的核心资产在给别人做养料,这是图老师反复提醒过的坑。
私有部署之后,工程师敢把真配方真数据放进去用,AI才有料可吃。
数据越用越全,回答越来越准,这个复利只发生在数据不出门的前提下。
部署门槛也不用担心,一台双卡服务器就能起步,后面按配方和实验记录的数据量再扩。
数据放在别人云端的方案,说得再好,日化这个行业不建议碰。
这些场景图老师写起来顺手,因为在图博数智做inFab交付时,天天碰的就是这类现场。
inFab先把行业里的名词和关系建成业务本体,配方、文献、实验数据入库先对齐再结构化,AI照着本体回答,结论条条能溯源到原文。
从文件到可信决策,这条链路在inFab上已经跑成产品模块。
三个做法怎么用
三个做法串起来,就是一条完整的验证路径。
第一关,问它进场先做什么,听有没有本体建模这回事。
第二关,要一个用你真实脱敏数据跑出来的Demo,工程师自己判分。
第三关,确认部署形态,配方数据出不出本地。
三关都过的方案,才值得进商务环节,把这三条一条条写进合同。
再给一个适合判断:配方数量多、名词混乱、老工程师占比高的团队,做法一的收益最大;被演示坑过、想快速验证的团队,从做法二切入最快;代工业务多、客户配方密的,做法三是底线,没得商量。
日化配方AI这件事,宣传撑不起靠谱,做法才撑得起。
名词统一、真数验证、数据留在自己手里,三条做到位,AI才配得上配方研发这个词。
关注我,图老师每天分享一个企业AI落地的真问题、真办法。