
稳定性考察数据散在表格里日化研发的3个真实管法
稳定性考察数据散在表格里?日化研发的3个真实管法
最近碰到一个客户,一家日化企业的研发负责人,聊到稳定性考察这件事,直接打开电脑给图老师看。
桌面上十几个文件夹,加速试验一批、长期留样一批、中试放大又一批,pH、粘度、微生物、感官描述,全躺在各自的表格里。
他说的痛点很具体:想看某个配方三年来的pH走势,要把七八个表格拼起来手工对时间点,一下午就没了。
拼完还要人工核对版本,万一拿到的是旧版表格,结论直接就错了。
这不是个例,稳定性考察是日化研发日常量最大、周期最长的数据类型,也最容易散。
监管要留痕、研发要复盘、质量要追溯,三头都要用这批数据,但底座一直是散的。
数据散一天,这些事就继续靠人肉扛一天。
今天图老师讲3个真实管法,都是围绕AI知识库怎么管这类数据展开的,做护肤、洗护、家清的团队都能对上。
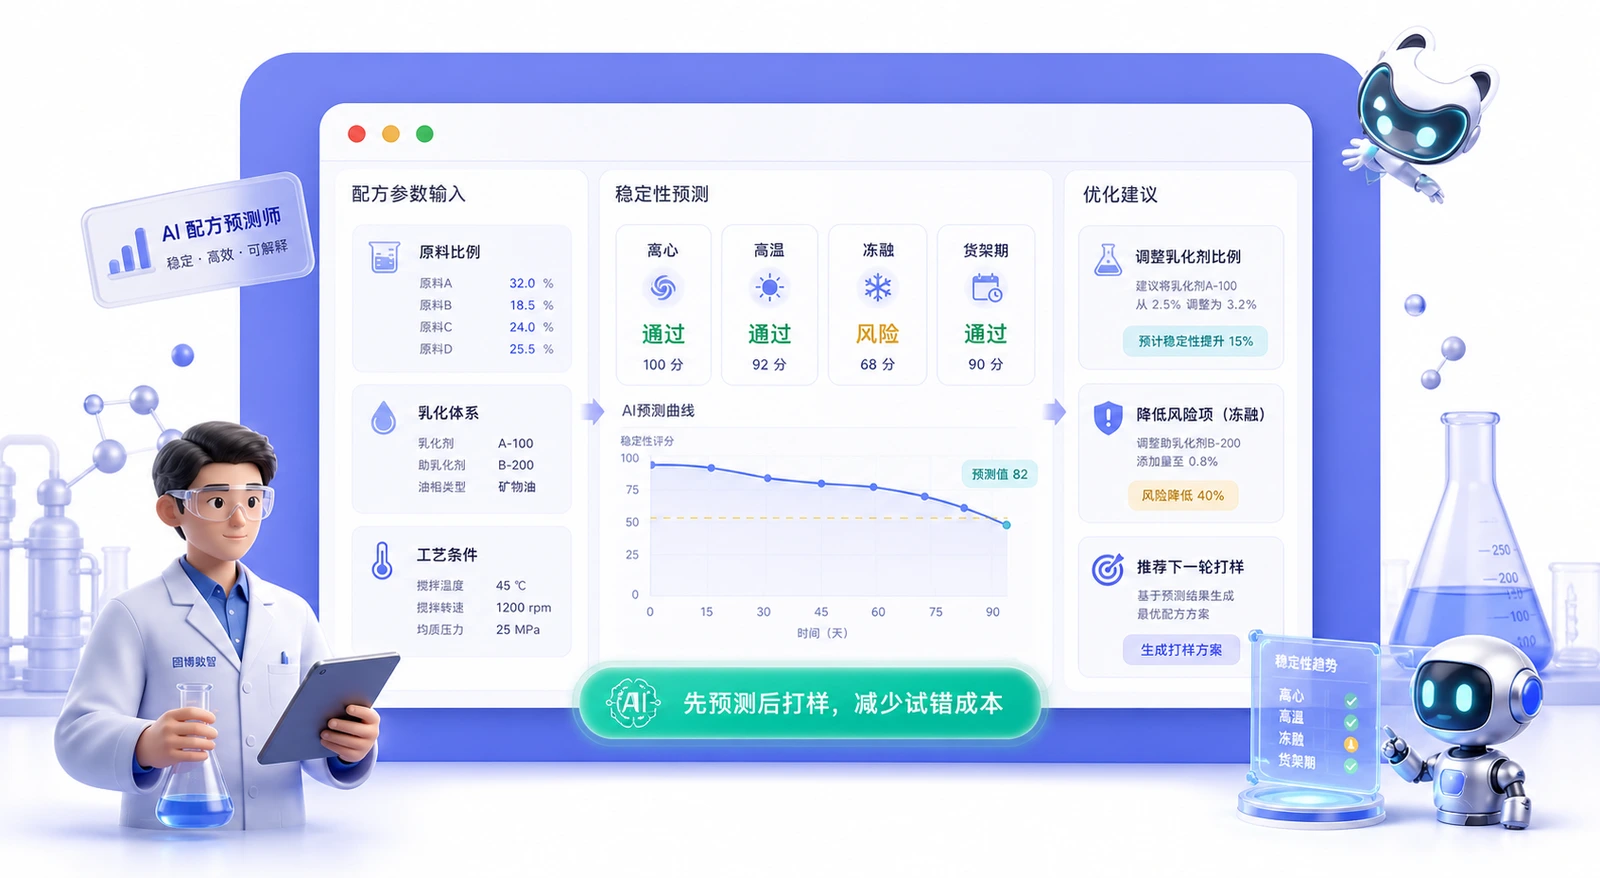
稳定性数据为什么难管
先说清楚这类数据特殊在哪。
稳定性考察一跑就是几个月到几年,同一个批次要在多个时间点反复测,数据天生是纵向的。
它还牵扯多条件:加速试验一个温湿度,长期留样一个温湿度,外加光照、低温、循环这些考察条件,每种条件各一套数。
检测项目又杂,理化指标、微生物、包装相容性,常常分属不同实验室甚至外部检测机构,表格式样都不统一。
更要命的是换人,当初记表的工程师调岗了,表格里的批号规则、缩写含义,就没人说得清了。
所以问题的根子在于数据没有归属,每张表格都是孤岛,串不起来就等于没用起来。
很多团队试过用共享盘加统一模板来解决,结果是新数据规范了,历史数据还是老样子,断层照旧。
考察数据自动汇管
第一个管法,把散在各处的考察数据汇到一个库里。
做法是让AI去读这些表格,不管是实验室自己的记录表,还是检测机构返回的报告,统一解析成结构化数据入库。
关键在元数据:每条pH读数后面,自动挂上产品、配方版本、批次、考察条件、取样时间点。
这层信息以前靠人在表格里手工备注,现在解析的时候自动补齐,出错率也降下来了。
这样数据从"某个表格里的某个格子",变成"某配方某批次在加速条件下第六个月的pH"。
入库之后,检索方式彻底变了。
想调某产品所有批次的粘度记录,不用再翻文件夹,一句话出来,表格在谁电脑里已经不重要了。
新一次取样数据进来,按同样的结构自动归位,库自己越长越全。
图博数智服务的一家日化企业就在做这件事,历史考察数据批量进库之后,新人第一周就能查到五年前的留样数据,这在以前要靠问老员工。
汇管还有一个隐性好处,检测机构的报告原件和解析出的数据一起归档,补资料、应对检查的时候,出处一步到位。
异常趋势提前预警
第二个管法,让数据自己开口说话。
散在表格里的时候,异常是看不见的:某批次pH每月偏移零点几,单看每个时间点都合格,拼在一起才看得出趋势。
人肉拼表不可能常态化,所以很多漂移要等到出结果了才发现,留样期白白耗掉几个月。
AI知识库的做法是持续对照:某批次的指标走势,自动跟同配方历史批次的走势比。
偏移速度明显快于历史水平的,主动提示出来,研发提前判断是配方问题、工艺问题还是存放条件问题。
预警还能看横向:同一时期多个批次一起往一个方向漂,多半指向原料批次或工艺条件,线索直接指向根因。
这就把稳定性考察从"到期看结论"变成"过程中盯趋势",问题暴露得越早,止损成本越低。
对日化研发来说,一次提前三个月发现的配方缺陷,省下的可能是一整轮重做。
图博数智在这类项目里反复验证过一点,预警规则不用一开始就定得很复杂,先盯住两三个关键指标就够用。
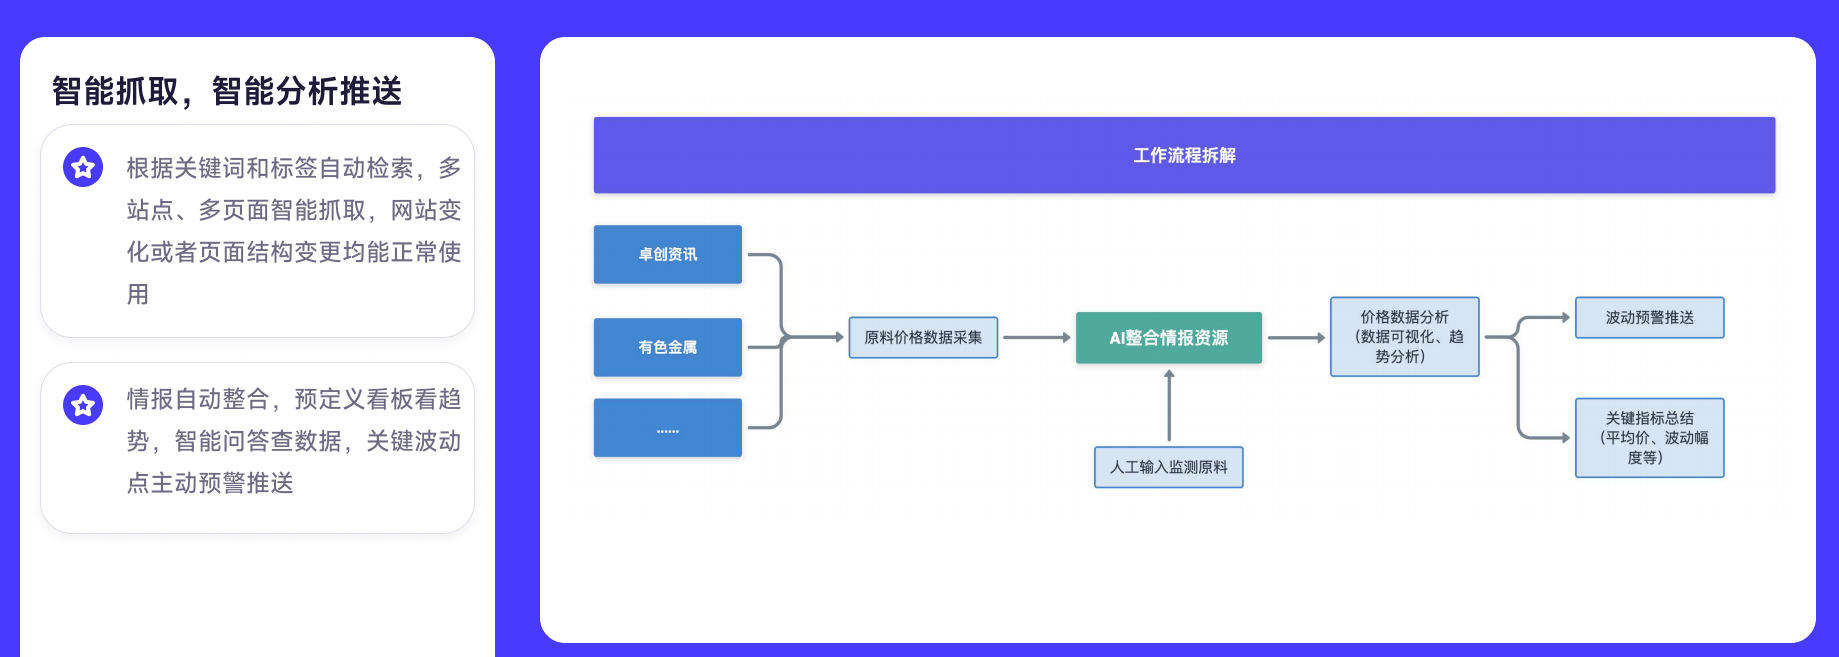
一句话追查考察结果
第三个管法,最直接的效率提升:用问的。
以前出问题的查法是,先确认产品,再找负责的工程师,再等他去翻对应的表格,一个来回一两天。
现在可以问:这个产品历次考察里,哪个条件最先出问题?
AI知识库顺着批次、条件、时间点的关系直接给答案,比如某产品多次考察都是高温条件下气味指标先超标,其他条件稳定。
再追问一句某次异常批次的详情,涉及的配方版本、原料批次、检测记录也能一并带出来,追问不用换地方。
这个答案的价值在于积累,问过一次,结论就沉淀在库里,下次换个人问,答案还在。
再往深一层,这些追查结论汇总起来,能反哺配方设计:哪类防腐体系在高温下容易出状况,哪种包装材质跟料体长期接触会迁移,都有据可查。
数据管起来之后,考察就不只是放行依据,更是配方迭代的输入。
这些场景图老师写起来顺手,因为在图博数智做inFab交付时,天天碰的就是这类现场。
inFab先把行业里的名词和关系建成业务本体,配方、文献、实验数据入库先对齐再结构化,AI照着本体回答,结论条条能溯源到原文。
从文件到可信决策,这条链路在inFab上已经跑成产品模块。
什么团队适合先动手
三个管法讲完,说说什么情况下值得先切这件事。
判断标准很实在:考察批次多、周期长、跨实验室的团队,收益最直接;一年就几个批次、单一人管表的,优先级可以放后。
数据现状也有个门槛,历史表格得基本可读,批号规则大致清楚,AI解析才有抓手,完全失联的数据救不回来。
从投入看,这件事不碰产线、不改配方流程,风险小,见效以周计,属于典型的低门槛切入。
落地节奏上图老师建议从一类数据起步,比如先把加速试验的数据汇管跑通,再扩到长期留样。
别小看这件事的复利,考察数据每年都在新增,早一年管起来,后面每年的查数、预警、追查全都站在这一年之上。
稳定性考察是日化研发里最磨人的日常,把它交给AI知识库管好,人才能去干真正值钱的活。
先从一个产品线跑通,见效了再铺开,这是图老师给所有日化团队的建议。
管法不难,难在开始管。
关注我,图老师每天分享一个企业AI落地的真问题、真办法。