
科研智能体能替研究生干什么3个真实实践
科研智能体能替研究生干什么?3个真实实践
最近碰到一个课题组的导师,聊起他的烦心事。
组里八个研究生,真正盯实验、想问题的不到一半,另一半人忙什么呢?查文献、整理数据、写周报、给新生答疑,全是事务性劳动。
他想问问科研AI到底能顶上多少,又怕吹过头:智能体真进场了,学生干嘛去?
图老师的看法一直没变:智能体接管的是事务,人回到思考本身。
这不是图老师拍脑袋,科研AI这一年的落地节奏确实变了——前两年大家聊的是模型多聪明,现在课题组问的都是非常具体的活:文献谁来筛、周报谁来整、新生的问题谁来答。
今天用3个真实实践说清楚,科研智能体到底替研究生干了哪些活,导师和学生都不吃亏。
科研智能体替查文献归类
第一个实践,文献综述的粗筛。
研究生开题,第一件事是查文献,几个数据库来回切,关键词换着花样试,查回来几百篇堆在文件夹里,再一篇篇看摘要归类。
这套流程跑下来,一两周就没了,产出还未必靠谱——归类标准全凭当天的状态。
一个开题方向粗筛下来,两三百篇文献很常见,真正值得精读的可能就二三十篇,中间那道筛子最吃时间。
而且这些辛苦有个特点:第二年师弟师妹接手课题,同样的检索再来一遍,上一届筛过的东西基本没留下。
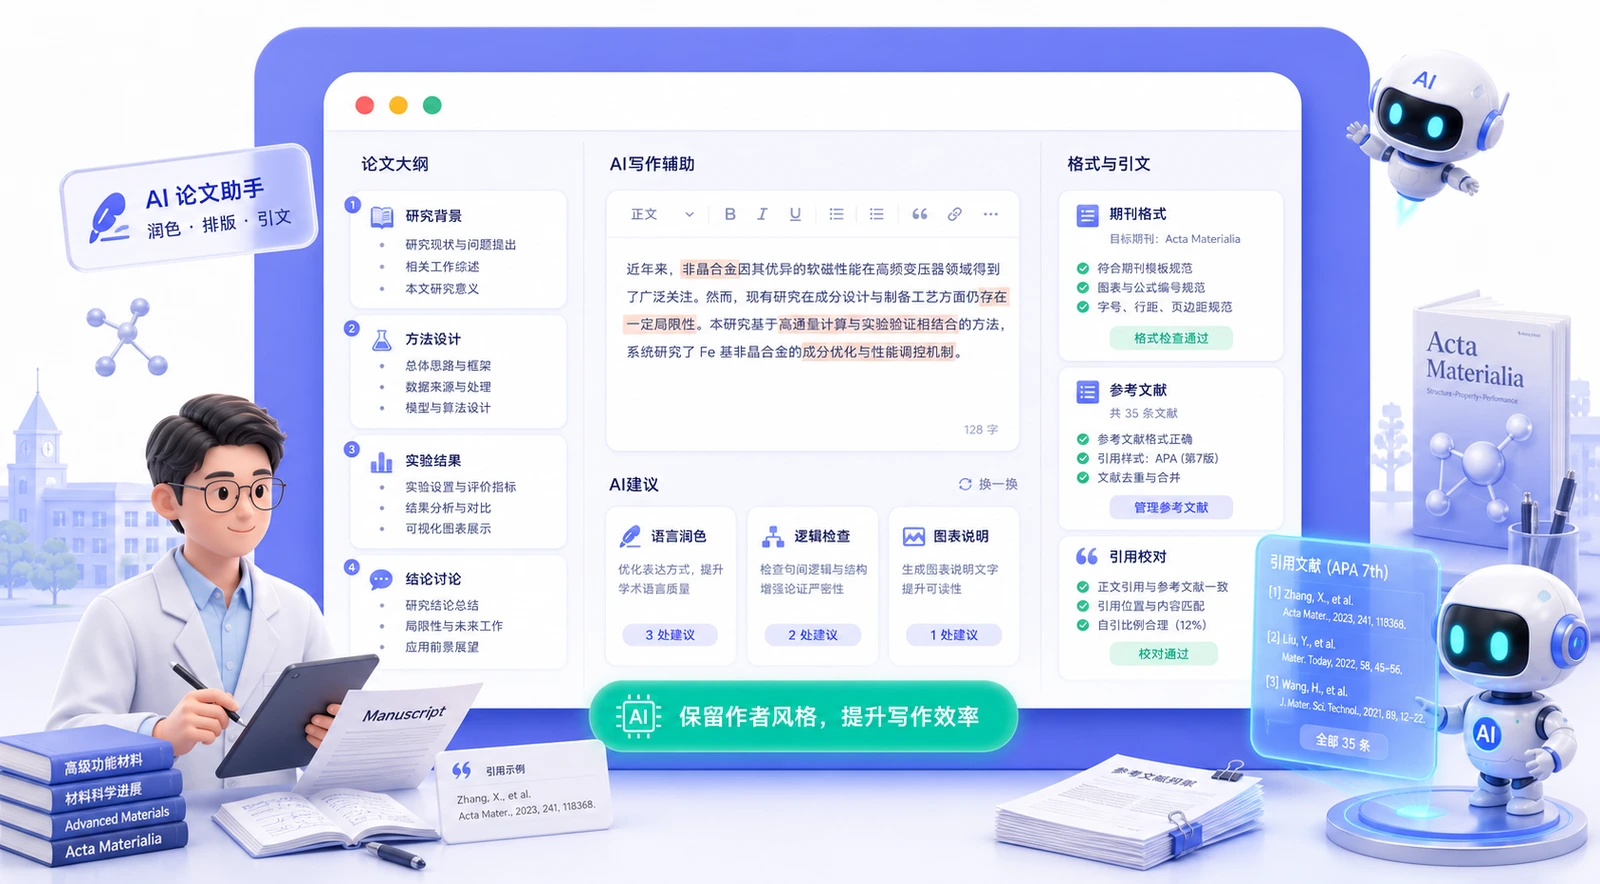
科研智能体的干法是:导师把课题方向和子课题拆好,智能体跨库检索,按子课题把文献归堆,每篇给一句"跟哪个方向相关、为什么相关"。
学生拿到的是分好类的清单,精读和批判性判断还是人来,这部分智能体不碰,也碰不了。
有人担心归类不准,这一步的机制是不让智能体瞎猜:归堆依据的是导师事先定好的方向描述,拿不准的文献单独放一栏,交给人定夺。
一个博士生的用法更细:让智能体每周扫一遍新出的文献,只把跟自己课题强相关的挑出来,附一句话摘要。
他说以前每周花大半天追文献,现在半小时看完摘要就知道哪篇值得精读。
省下来的时间是小事,更值钱的是检索结果留了底:哪些文献看过、归到哪个子课题、当时的判断是什么,第二年交接时直接继承。
图博数智做科研AI方案时,论文智能体这个场景是被课题组提需求提得最多的,说明查文献归类确实是刚需痛点。
科研智能体替写周报初稿
第二个实践,实验数据自动变成汇报初稿。
研究生每周都在干一件事:把散落的实验记录、仪器导出的数据、失败的尝试,整成周报或者组会PPT。
这活技术含量不高,但极耗时,格式调整、图表对齐、数据誊抄,一个下午就搭进去了。
更亏的是,整理的过程里人根本没在思考数据,只在思考排版。
科研智能体接过来之后流程变成:实验数据进知识库,智能体按组里固定的周报模板,自动汇总本周做了什么、数据走势如何、异常点在哪,生成初稿。
数据从仪器导出到变成初稿,中间那几小时的搬活没有了,学生只在初稿上改。
模板是组里自己定的,先放数据表还是先放异常分析,按组里习惯来,智能体照着填,不用迁就任何工具的默认格式。
学生拿到初稿只干一件事:看数据,想问题,写自己的判断。
组会上导师问"这个异常你怎么解释",答得上来才是真本事,排版答不上来。
有个导师的观察很准:初稿变快之后,组会上被问卡壳的学生反而多了,因为时间都花在想数据上,问题也问得更深。
有学生说得直白:我从排版工人变回了看数据的人。
一周省半天,一个学期下来就是十几天,这还是只算周报,算上组会PPT和中期汇报更多。
这一条的核心价值就在这,事务性劳动让出去,研究生的时间还给科研本身。
科研智能体替师兄答疑
第三个实践,课题组新生的问题,交给组内智能体回答。
每个课题组都有个隐形岗位:师兄师姐的人肉FAQ。
这个岗位没人任命,默认落在入学第二年的学生头上,问的人多了,自己的进度就得往后让。
仪器怎么预约、试剂配多少、这台设备操作前要注意什么、报销流程怎么走,新生一天问八遍,师兄自己的实验全靠晚上加班补。
这些问题的答案其实都有——仪器预约制度、试剂用量规范、操作规程,全躺在组里的文档和群公告里,只是新生不知道去哪找。
拿试剂用量来说,规程里写得清清楚楚,但文档名是一串编号,新生根本想不到点开的是它。
群公告翻几百条,文档散在好几个文件夹,问师兄最快,所以师兄成了受害者。
科研智能体基于组内文档回答这些问题,答案带出处,指向哪份规程第几条,新生自己就能核对。
规程改了版,把新文档替换进知识库,回答自动跟着变,不会出现智能体还在教旧操作的老问题。
跟直接问公网AI最大的区别在这:回答只来自组内文档,实验细节和内部数据不出本地。
新生上手快了,师兄被问烦的次数少了,导师也不用在群里反复回答流程问题。
三赢,而且没有一分钱人力成本增加。
图老师在图博数智做inFab交付,科研团队是inFab用得最深的一批用户。
课题组文献、实验数据、导师经验建成业务本体进inFab,AI照着本体回答,结论能溯源到原文。
从文件到可信决策,课题组自己攒的知识,自己最先受益。
智能体不碰什么
说到这,把边界也讲清楚,免得有人误会。
智能体替的是查、整、答这类事务,选题判断、实验设计、数据解读、论文的核心论证,一步都没让出去。
拿第一个实践说,智能体把文献分好堆,判断这篇方法能不能借鉴、那条路线为什么走不通,还是研究生的功课。
科研AI落到课题组,改的只是时间的分配,替代不了任何一次真正的思考。
判断哪些活可以交给智能体,标准就一条:这活是不是有固定流程、有现成文档依据的?是,就能交;要动脑子的,留给人。
图博数智的科研方案里,智能体跑在私有化环境上,组内数据、未发表的实验记录不出本地,这点对课题组比效率更重要。
导师担心的"学生没活干"不会发生,学生只是不再被事务淹没。
真到组会那天,被问住的还是没想清楚数据的人,智能体帮不了这个忙,也不该帮。
先从一个场景试起,比如先让智能体接管新生答疑,跑顺了再加文献和数据这两块,别一上来就想全替。
试的时候盯两个信号:新生是不是真的不问师兄了,回答里有没有出现过时内容,有这两条,这个场景就算立住了。
科研智能体不是来抢活的,是把研究生从杂活里捞出来,这话图老师放在这,一年后可以回头验证。
关注我,图老师每天分享一个企业AI落地的真问题、真办法。