
失败配方也是数据资产AI知识库怎么用3个真实做法
失败配方也是数据资产,AI知识库怎么用?3个真实做法
前阵子跟一家做材料配方研发的企业聊数据梳理,看到一件事。
工程师把实验记录导出来分成两堆,一堆是打样成功的配方,一堆是失败的,失败那堆单独放一个文件夹,备注写着待清理。
他问我,这些没用的数据,删了吧。
我说先别动,这可能是全部数据里最值钱的一堆。
他愣了一下,大概在想,失败的东西怎么还值起钱来了。
这个场景太典型了,十家做配方的企业,九家的失败数据都是这个待遇。
今天专门讲讲,失败的配方怎么变成数据资产,AI知识库在里面干三件事。
失败配方为什么值钱
先解决观念问题。
很多团队觉得失败记录占地方,没用处,还多少有点丢人。
失败在报表上不好看,在数据里可是硬通货。
换个角度算笔账。
实验室里每一条失败的配方,都是花真金白银试出来的,原料投进去了,工时和检测费也都付了,结论是此路不通。
花同样的钱买到的信息,用一次是成本,用一百次是资产。
把这个结论扔掉,等于学费白交。
这些钱已经花出去了,唯一能回本的方式,就是把结论留下来。
AI只学好配方,会把你踩过的坑当成新路,再踩一遍。
好的配方教AI什么是好的,失败的配方教AI边界在哪。
两个方向都有记录,研发的地图才是完整的,只有好案例的地图,一半是空白的。
老师傅和新手的差距,往往也在这里,老师傅知道哪条路走不通。
一家企业真正的研发积累,一半藏在它不做什么里。
做法一失败要带死因入库
第一条做法,失败数据要带死因。
一条失败的配方记录,三段要齐:研发目标,当时想干什么;过程数据,成分配比加工艺参数;失败原因,测试数据加具体死因。
只写一个失败的结论,没有过程没有原因,这种数据删了确实不可惜。
带死因的,条条是真金。
同样一条失败,只写失败两个字,AI读不出任何信息,写清楚死因,它就成了边界数据。
死因要具体,稳定性不达标、析出、分层、相容性出问题、工艺窗口太窄、成本超了,各不相同。
写清是高温下析出还是低温下分层,比一句稳定性不行值钱十倍。
失效模式记得越清楚,AI以后避得越准。
很多团队死因记在个人笔记本里,人一转岗,这条失败就等于没发生过。
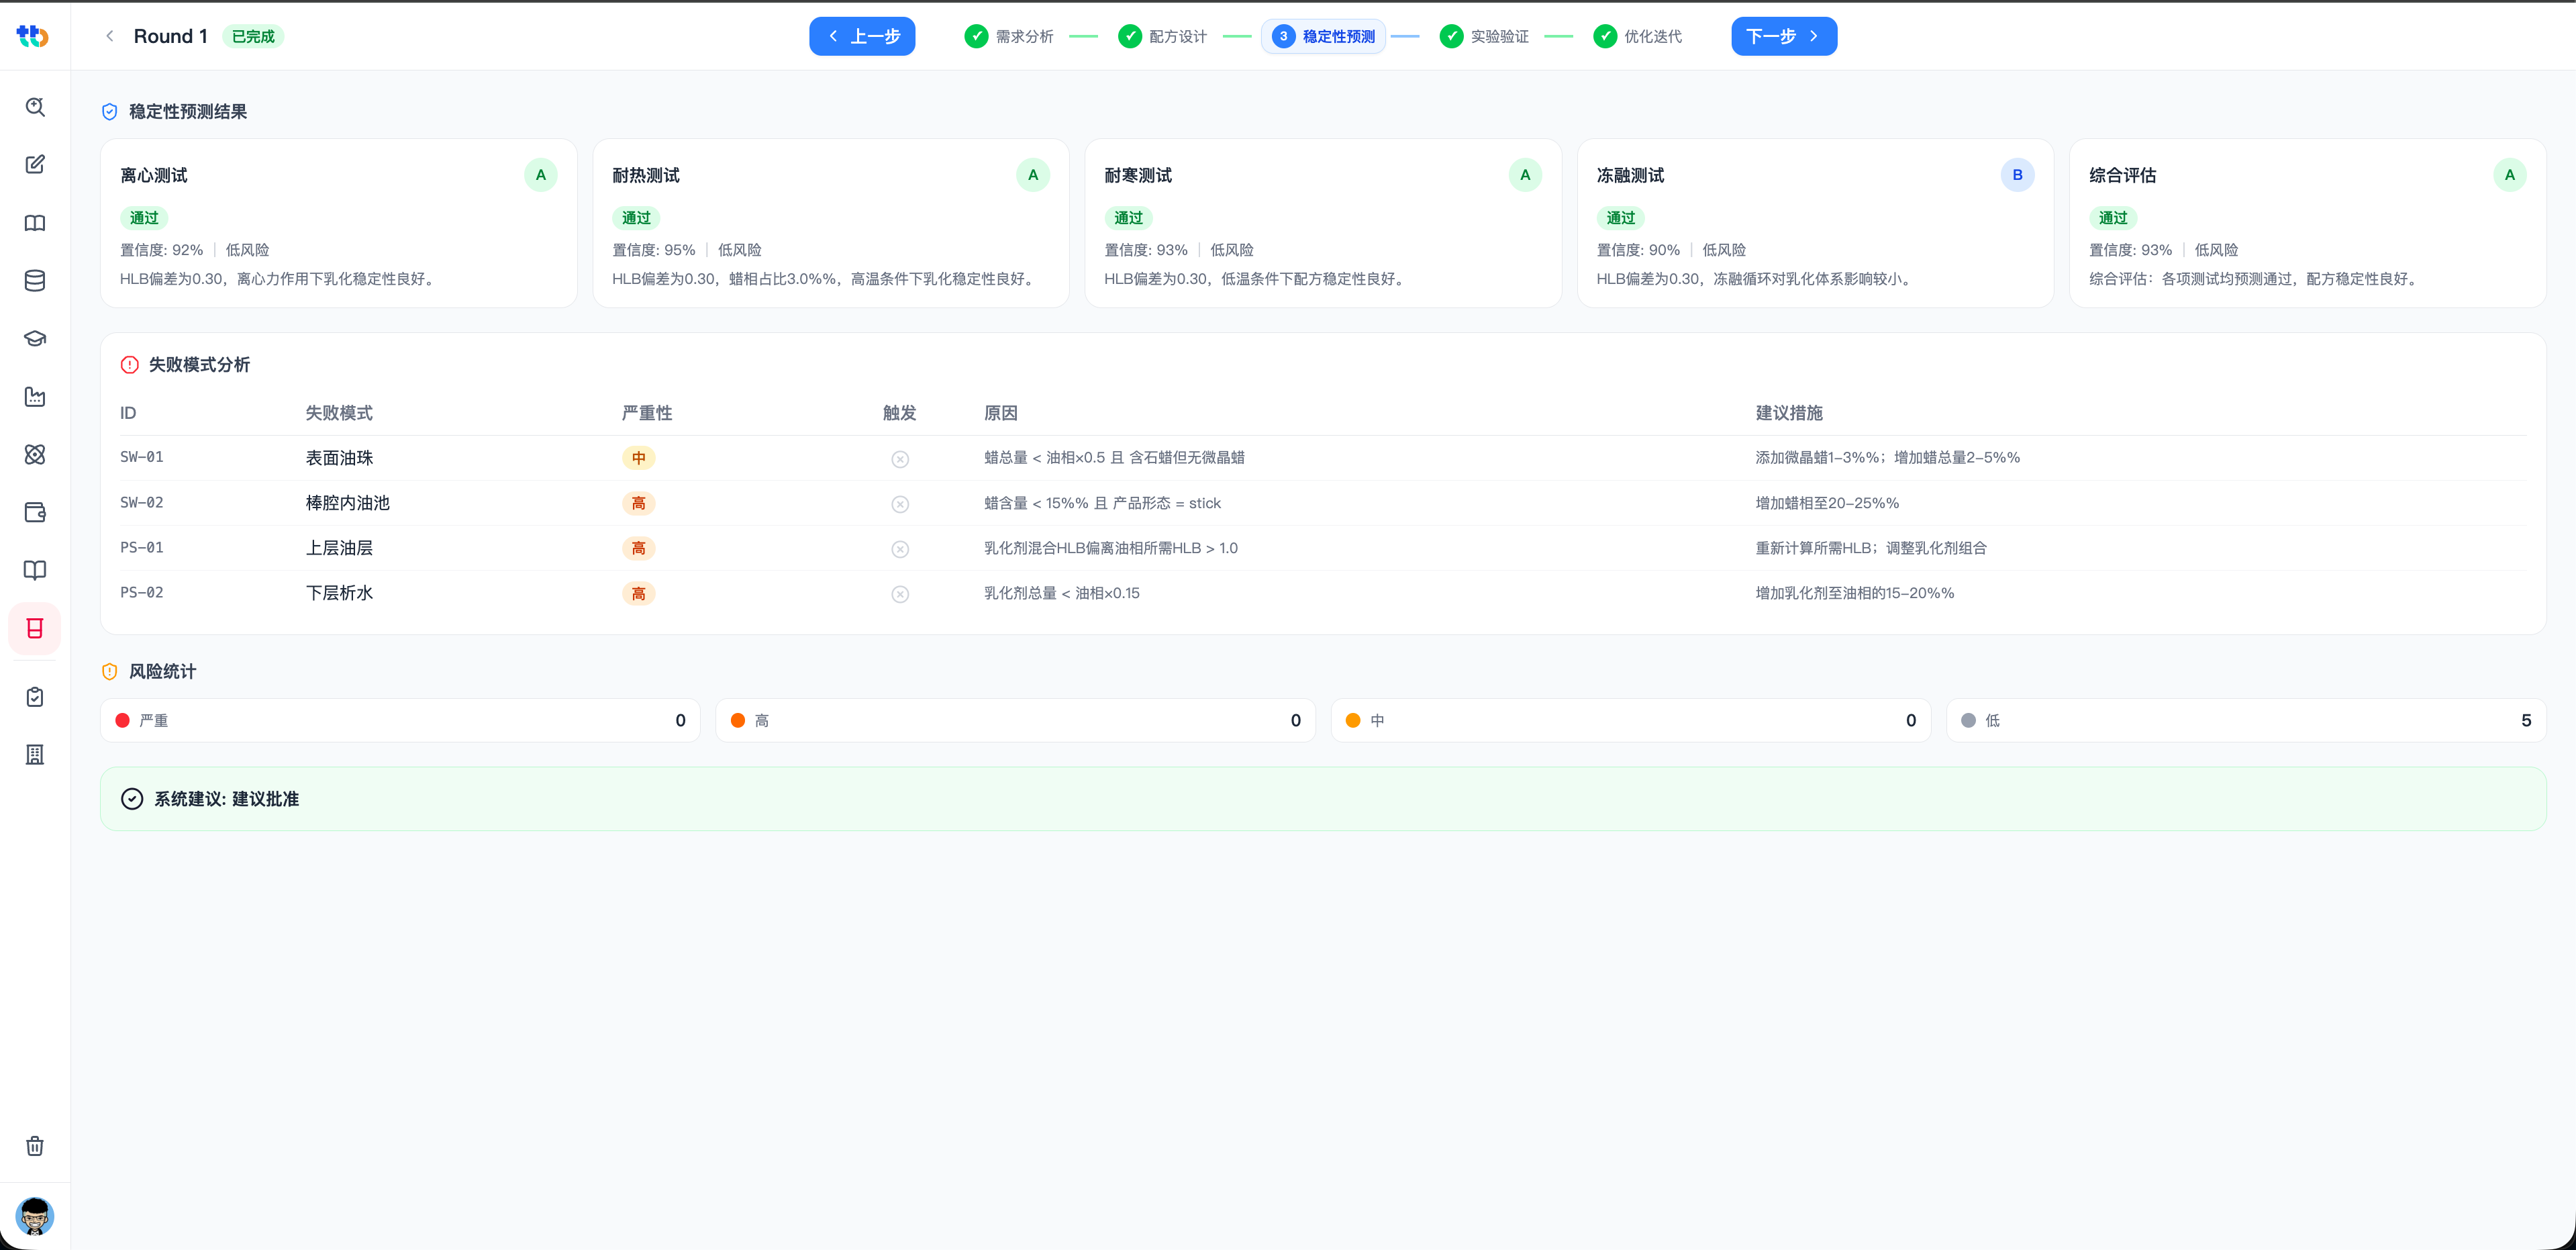
图博数智的inFab知识库里,失效模式是独立字段,严重性、触发条件、原因、预防措施分开记,为的就是让每一条失败都能被AI读懂。
字段拆得细,看着繁琐,换来的是失败可以被检索、被统计、被绕开。

做法二好坏数据成对喂
第二条做法,good和bad成对喂。
有个说法叫双向数据库,好案例和坏案例两个方向都建。
单向的库只能回答什么行,双向的库才能回答什么不行,研发天天要回答的恰恰是后者。
只喂好数据,AI学会的是模仿。
好坏一起喂,AI学会的是判断,这个组合大概率行,那个组合三年前就栽过。
落到场景里,新品立项,工程师把性能目标输进去,系统先检索历史相似记录。
不用翻笔记本,不用问老人,几秒钟的事。
成功的给参考,失败的给红线,这几种组合历史上析出过、分层过,直接绕开。
参考和红线一起摆出来,判断还是人来下,但依据从个人记忆换成了全量历史。
一轮打样的原料、工时、检测费,就这样在电脑上省掉了。
省的还只是看得见的钱,周期的账更大,打样一轮短则几天长则几周,绕开一轮,进度就抢回一轮。
比竞品快一步,市场窗口就宽一分,这笔账老板最算得清。
图博数智给化工材料企业建配方知识库,双向数据库是标配动作,第一批要的脱敏数据里,失败案例是点名要的。
做法三让新人绕开老坑
第三条做法,把失败案例变成传承。
这是失败数据最容易被低估的用法。
研发团队最怕的事,老工程师走了,哪些路走不通,没人知道了。
新人进来,把老坑重新踩一遍,学费再交一轮。
更隐性的是决策退化,没人知道老路线为什么被放弃,团队会反复讨论早有答案的问题。
有意思的是,这件事的解法就藏在失败数据里。
失败案例进了AI知识库,新人问一句,这个体系之前有人试过吗,系统给出历史尝试、失败原因、当时的工艺条件。
判断依据摆在那,新人不必靠碰运气建立经验。
经验里说不做什么的那一半,就这样留下来了。
过程难追溯的老问题也顺手解开一半,谁试的、怎么试的、为什么放弃,链条都在。
这套库建起来,团队里谁走了,库还在,坑的记录还在。
什么样的失败值得留
再给个判断,别走极端。
留不留,看两条。
过程记录完整的留,只有结论没过程的,删了不可惜。
介于两者之间的能救,找当时的负责人补记一段死因,几分钟的事。
能脱敏的进库,脱不掉的不进,机密数据宁可不喂。
还有一条底线,失败配方往往比成功配方更敏感,它是企业试错路线的全貌。
所以这套库必须跑在私有化部署的环境里,数据不出企业,公网AI学走的每一个失败,都是送给同行的情报。
保密等级这一条,失败数据和核心配方同权重,甚至要更严。
从一批待清理数据开始
怎么起步,不用轰轰烈烈。
就从那批待清理的失败数据开始,挑几十条过程完整的做脱敏,连着成功案例一起,搭个小样AI知识库先跑起来。
小样的意义在验证,几十条数据足以让团队看清这件事值不值得做。
检索准了,红线灵了,再扩全量。
哪一步不灵,回到数据本身找原因,别急着换工具。
图老师的一句话建议:下次清理数据之前,先看一眼失败那一堆,那里面睡着的,可能是你最值钱的数据资产。
一句结论可以单独记下:配方数据的价值,一半在成功里,另一半在你把失败整理成了什么。
关注我,图老师每天分享一个企业AI落地的真问题、真办法。