
日化配方数据怎么整理才能用3类数据1个底座
日化配方数据怎么整理才能用?3类数据1个底座
最近跟几家日化企业聊AI落地,发现一个共同现象。
聊到AI能干什么,大家兴致都高。
聊到第一步干什么,气氛就静了。
因为第一步绕不开一件事,把配方数据整理出来。
而这恰恰是大多数日化企业最头大的环节,数据散在四方,谁都说不出全貌。
今天图老师把这件事拆开讲,日化研发的数据就三类,每类的乱法不一样,治理的路子也不一样,最后合成一个底座。
先说整理的总体原则,一句话,别追求一步到位。
数据整理是持续工程,第一遍的目标是能查,第二遍才是好用,第三遍是越用越准。
想着一次整理到完美的企业,多半停在第一步。
接受不完美、边用边补的,反而三个月就有产出。
下面分类讲,每类数据怎么落到能查。
第一类配方数据乱在版本
第一类,配方本体数据,配比、原料、工艺参数。
这类数据的价值最高,乱得也最有特点。
乱在版本。
一个成熟配方迭代十几版是常态,改个增稠剂调个香精量都算一版。
这些版本散在共享盘、邮件附件、老师傅电脑里,文件名靠后缀区分,v2final、v2final新、v2最终版,懂的都懂。
乱在命名。
同一个原料,采购叫商品名,研发叫INCI名,配方师之间还有行话简称,一个东西三四个叫法,统计都统计不准。
整理配方数据,干三件事。
归集,所有版本收进一个库,先求全再求精。
定名,原料命名统一,一个原料一个标准名,其他叫法挂别名。
版本链,每个配方挂上版本历史,哪版生效、哪版废弃、为什么改,链式记录。
整理完的标志是,随便说一个产品,两分钟调出它现在生效的配方和全部历史版本。
第二类实验数据乱在分散
第二类,实验和打样数据,测试结果、稳定性记录、感官评价。
这类数据的乱法和配方不同,乱在分散。
仪器导出的测试数据在检测电脑里。
打样记录在实验记录本上,手写的。
稳定性跟踪在Excel里,谁跟的项目谁管。
感官评价在群里,一段段语音和文字。
分散的结果就是查不过来。
想回答这个体系半年前做过哪些尝试,除了问当事工程师,没有第二条路。
整理实验数据,也干三件事。
转录,手写记录和截图数据录入结构化表格。
关联,每条实验记录挂上对应配方版本,实验跟配方对得上号。
补全,关键条件缺的补上,补不上的标注。
南京大学的课题组给MatSeek建数据底座时走的就是这条路,文献、实验数据、组内记录统一结构化,检索精准度做到95%以上。
企业配方数据的治理,逻辑完全同构。
第三类文献标准数据乱在庞杂
第三类,文献和标准数据,国标行标、技术论文、原料供应商资料。
这类数据的乱法是庞杂。
行业标准一堆,国内的国际的,隔几年修订一轮。
供应商的技术资料每家一套格式,COA、TDS、MSDS,文件格式五花八门。
技术文献就更不用说了,量无限大。
这类数据单条看着都有用,堆在一起就成了找不到的宝藏。
整理这类数据,重点是结构化。
标准条款拆成可检索的条目,什么原料限多少量,适用什么产品类别。
供应商资料按原料归档,一个原料挂全部供应商文件。
文献按体系打标签,要查某个体系,相关文献一起调出。
整理完的标志是,研发问一个合规问题,三分钟内给出标准原文出处。

三类数据合成一个底座
三类数据各自整理好,最后一步是合成。
合成不是拷到一个文件夹,是打通关系。
配方关联实验,每个配方版本挂上它的打样记录和测试结果。
配方关联原料,每个原料挂上它的供应商资料和历史批次。
原料关联标准,每个原料挂上它受约束的法规条款。
关系打通之后,问一个综合问题,三类数据一起出面。
这个产品的现行配方是什么,历史稳定性表现如何,原料有没有合规风险,一次答全。
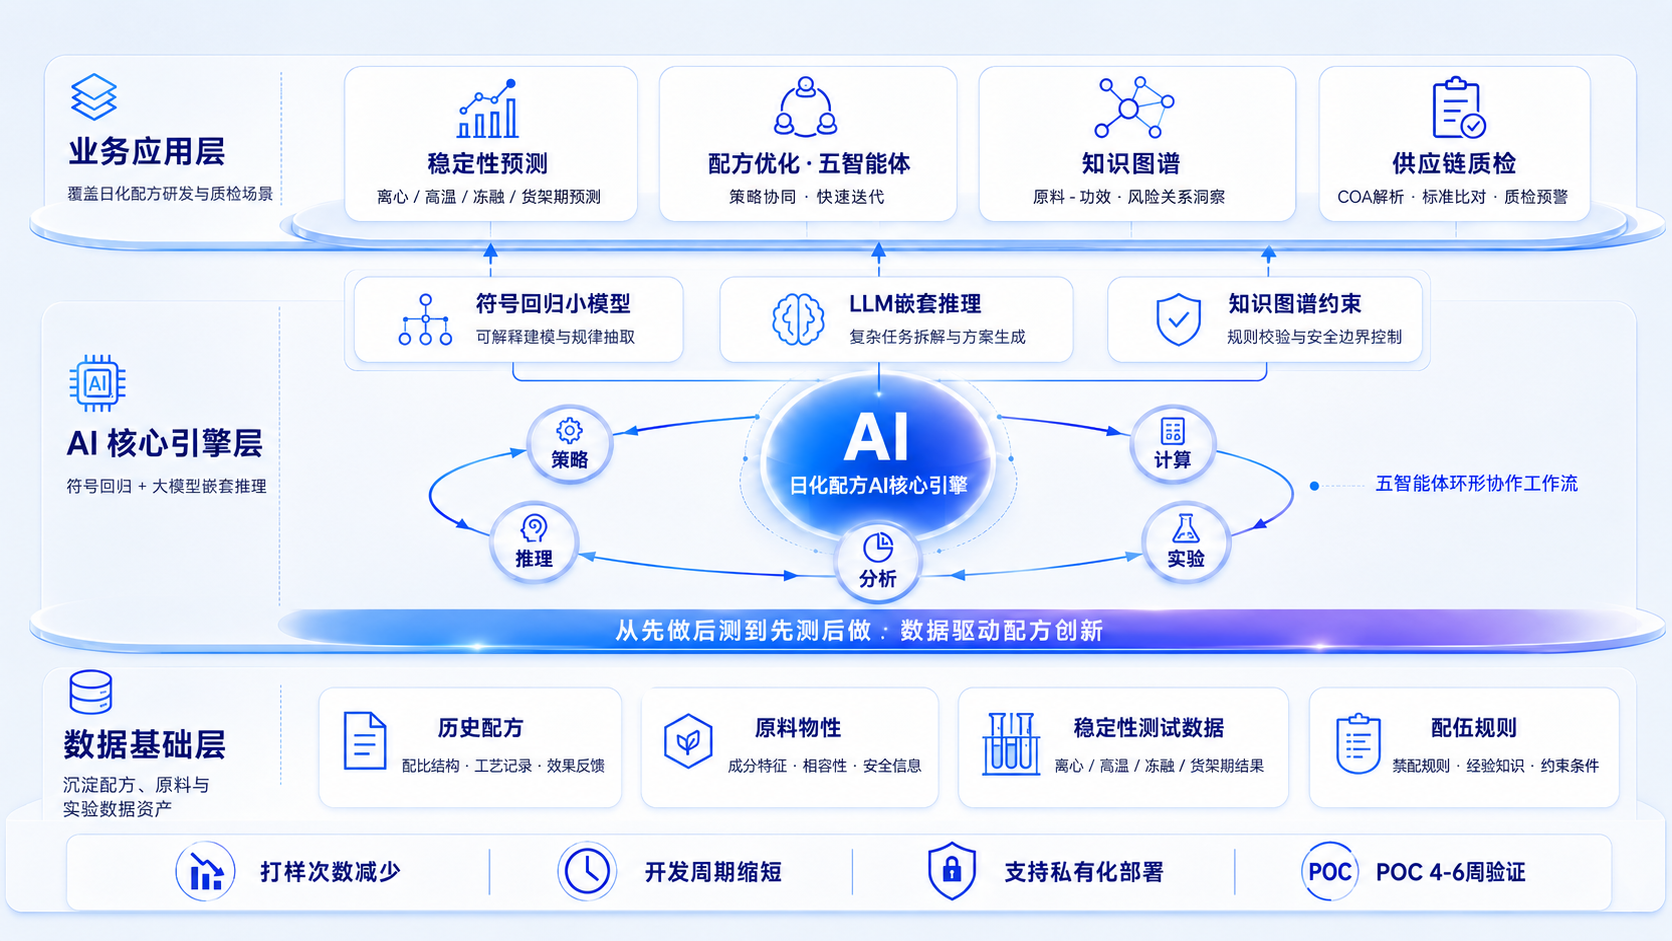
这就是知识底座,AI配方能力的全部地基。
检索、推荐、预判、合规检查,所有AI能力都跑在这个底座上。
底座的厚度,决定AI能力的天花板。
图博数智给日化客户做落地,第一步永远是帮着建这个底座,inFab知识库平台就是干这个的。
inFab是国内首家依托业务本体建模的产业级AI知识库平台,配方、实验、标准三类数据入库后,名词统一、关系打通、检索带溯源,这一整套正是它的主场。
FDE团队进场先贴着你们的业务把原料命名和配伍规则理清楚,这个苦活inFab接得住,理得越细,后面AI的能力越稳。
三类数据合成的底座建在inFab上,数据归企业,平台私有化部署在内网。
整理过程中的三个坑
数据整理听着机械,坑不少,图老师提前给你标出来。
坑一,追求完美。
想着把所有历史数据全整理完美再开始,三个月过去还没入库。
正确姿势是先跑框架,代表性数据先入,边用边补。
坑二,只整理不关联。
数据入了库但关系没建,配方是配方实验是实验,查起来还是两套系统。
关系打通才是底座,不然只是个网盘。
坑三,没有维护机制。
一次性整理完就不管了,三个月后新数据又散落各方,回到原点。
定一条规矩,新数据产生即入库,谁产生谁负责。
整理从哪开始
三类数据一起动手,必然烂尾。
图老师给的顺序是,配方数据先行。
原因两个。
一是配方数据是核心资产,价值密度最高,先整理先受益。
二是配方数据量相对可控,一个季度能见成效,团队有正反馈。
实验数据第二步,文献标准第三步,穿插着做。
启动的成本也没那么吓人。
最后给个心理预期。
整理这件事,第一遍最累,第二遍减半,第三遍开始变成习惯。
按模板记录的新数据,入库成本几乎为零,累的只是回填历史。
熬过头三个月,后面是顺水推舟。
先从最近两年的新配方开始规范录入,新数据不欠账,历史数据逐步回填。
最后算一笔时间账。
配方数据先行,一个季度。
三类全通,加维护习惯养成,半年到一年。
听起来不短,但这个底座是资产,建一次用十年,摊到每年,成本可忽略。
判断标准一句话:三类数据不用一次理完,但关系框架要一次搭对,框架对了,往后每条新数据自动归位。
一句结论可以单独记下:日化AI落地的第一步不是选模型,是把三类数据理成一个底座,数据理顺了,AI的能力是水到渠成的事。
关注我,图老师每天分享一个企业AI落地的真问题、真办法。